SOProyecto Integrador
Debian 13
Entregables

Sistemas Operativos · Universidad Surcolombiana · 2026-2

PROYECTO INTEGRADOR en Debian 13

Operable. Seguro. Documentado.
Tres entregas contadas desde la terminal.

AutoresJuan Esteban Bustos Chilatra
Juan Sebastián Tafurth Cortés
DocenteClaudia Marcela Cano Calderón
EntregaSemana 15 · Parte III
darknesspain@servidor: ~/entrega3
$ sudo ./verificar_servidor.sh
[ OK  ] Swap activo (archivo /swapfile)
[ OK  ] /datos es ext4
[ OK  ] /datos esta en fstab por UUID
[ OK  ] ACL: usuario 'lector' con lectura
[ OK  ] Firewall ufw activo
[ OK  ] SSH sin contrasena (solo llaves)
[ OK  ] Hay conexion de red con 'cliente'
[ OK  ] SSH a 'cliente' con llave
-------------------------------------------------
RESULTADO: 20 de 20 comprobaciones correctas
█
20/20verificador
3 111MB de swap
4incidentes
168figuras
scroll

El proyecto integrador

Tres entregas,
un mismo servidor.

La Entrega 3 no empieza de cero: es la maduración del Debian que se instaló en la primera entrega y se exploró en la segunda. Aquí se convierte en un servidor que se administra a distancia, se protege, se respalda y se diagnostica.

Entrega 1

Virtualización e instalación

VirtualBox, creación de la VM y Debian GNU/Linux 13 instalado paso a paso. Después, el sistema se identifica con uname, hostnamectl, lscpu, free, lsblk, lspci y lsusb.

Partes I y II · Unidades 1 y 2

Ver la instalación
Entrega 2

El sistema por dentro

Procesos con ps, pstree, top, htop y la carga de uptime; señales con kill, prioridades con nice y renice; y tres scripts de Python: condición de carrera, productor-consumidor e interbloqueo.

Parte III · Unidades 3 y 4

Ver procesos y concurrencia
Entrega 3 · Parte III

Servidor, memoria, archivos y seguridad

Dos máquinas en red, swap y algoritmos de reemplazo, disco de datos con inodos y ACL, firewall, SSH con llaves, respaldos y cuatro incidentes resueltos.

Lo que se sustenta aquí

Empezar la Parte 0
E1

Entrega 1 — Partes I y II · Unidades 1 y 2

Primero,
la máquina.

VirtualBox instalado sobre Windows 11 y Debian GNU/Linux 13 instalado desde cero. Aquí nacen la VM, el disco de 20 GB, el usuario y el escritorio GNOME que tres entregas después se convertirían en el servidor. Al final de la entrega, el sistema se describe a sí mismo: distribución, kernel, CPU, memoria y discos.

RAM asignada3 047MBen la creación de la VM
vCPU2núcleosIntel Core i5-1035G4
Disco virtual20GBVDI reservado dinámicamente
Arquitecturaamd64ISO oficial de debian.org
01VirtualBoxInstalación en Windows 11 y Extension Pack
02La VM20 GB, 2 CPU y 3 047 MB de RAM
03La ISODebian 13 Trixie amd64
04InstalaciónGráfica, en español y teclado latino
05ParticionesTodo en una partición + swap
06GRUBArranque en /dev/sda

El hipervisor y la VM

Un equipo dentro de otro equipo

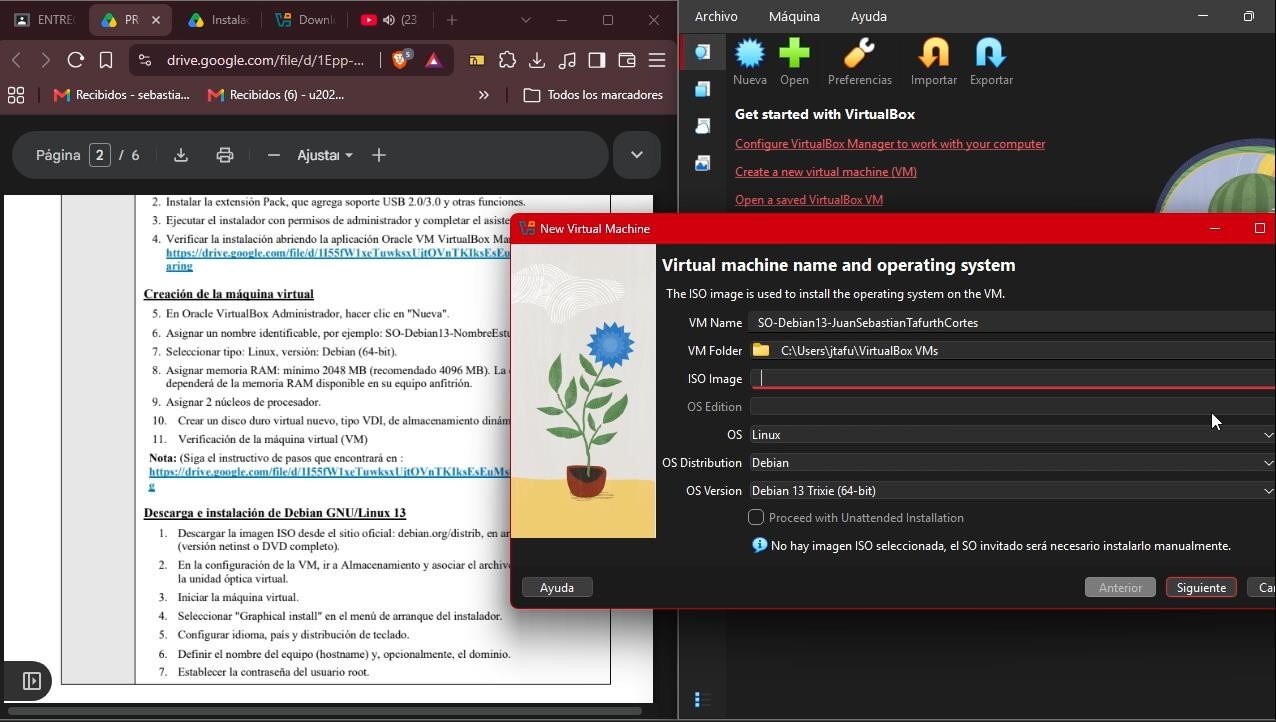
VirtualBox es un hipervisor de tipo 2: se instala como una aplicación sobre Windows 11 y desde ahí reparte CPU, memoria y disco a la máquina virtual. La VM se creó con nombre SO-Debian13-JuanSebastianTafurthCortes, tipo Linux, distribución Debian y versión Debian 13 Trixie (64-bit).

La ISO amd64 se descargó del sitio oficial y se montó en la unidad óptica virtual. La instalación se hizo en modo gráfico, en español, con país Colombia y teclado latinoamericano.

$ 20 GB de disco · 2 núcleos · 3 047 MB de RAM · amd64

La configuración inicial era de 3 047 MB. Para la Entrega 3 la VM quedó con 1 972 MB visibles, de modo que servidor y cliente pudieran estar encendidos al mismo tiempo.

Creación de la máquina virtual en VirtualBox
Fig. E1.1 La VM recién creada

Decisiones de la instalación
IdiomaEspañol
PaísColombia
TecladoLatinoamericano
Hostnamedebian-auntiedot
Usuariotafurth · UID 1000
Particionadoguiado · sda1 + swap
EscritorioGNOME + utilidades estándar
ArranqueGRUB en /dev/sda
Repositoriodeb.debian.org
La dificultad

Faltaban GNOME y las utilidades

En «Selección e instalación de programas» solo aparecía «Entorno de escritorio Debian»; no estaban las casillas de GNOME ni de utilidades estándar. Continuar así habría dejado el sistema sin entorno gráfico completo.

  1. Retroceder en el instalador
  2. Reconfigurar el gestor de paquetes
  3. Repetir la selección de programas
  4. Continuar: ya aparecen GNOME y las utilidades

Al reiniciar se verificó el arranque gráfico, el inicio de sesión, la conectividad y la actualización de repositorios.

Parte II — Identificación de características del sistema

¿Qué quedó instalado,
exactamente?

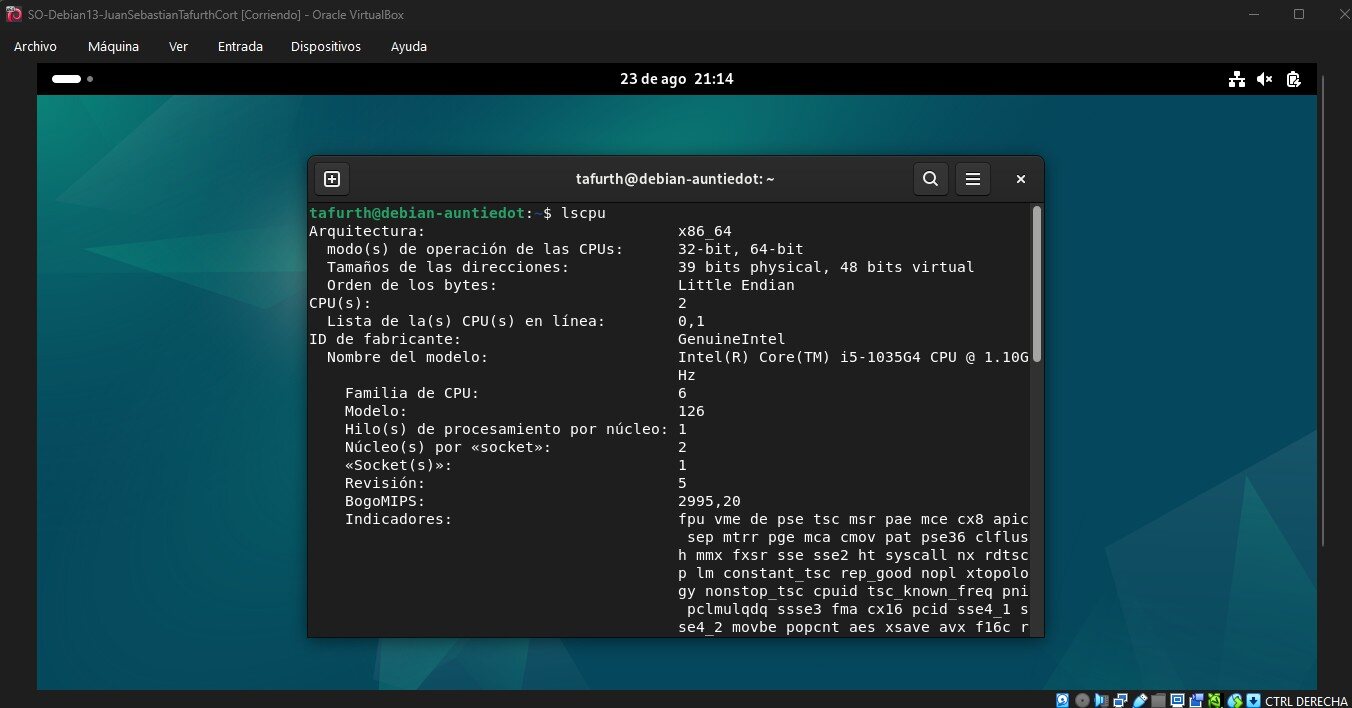
La instalación termina cuando el sistema puede describirse a sí mismo: distribución, kernel, arquitectura, CPU, memoria, discos y dispositivos. De eso se encargan uname, hostnamectl, lscpu, free, lsblk, lspci y lsusb.
DistribuciónDebian 13.6trixie
Kernel6.12.101+deb13-amd64
Hostnamedebian-auntiedotVirtualization: oracle
Arquitecturax86_642 vCPU · 1 hilo/núcleo
Memoria2,91 GiBswap 1,16 GiB

cat /etc/os-release · uname · hostnamectl

La distribución y el kernel no son lo mismo

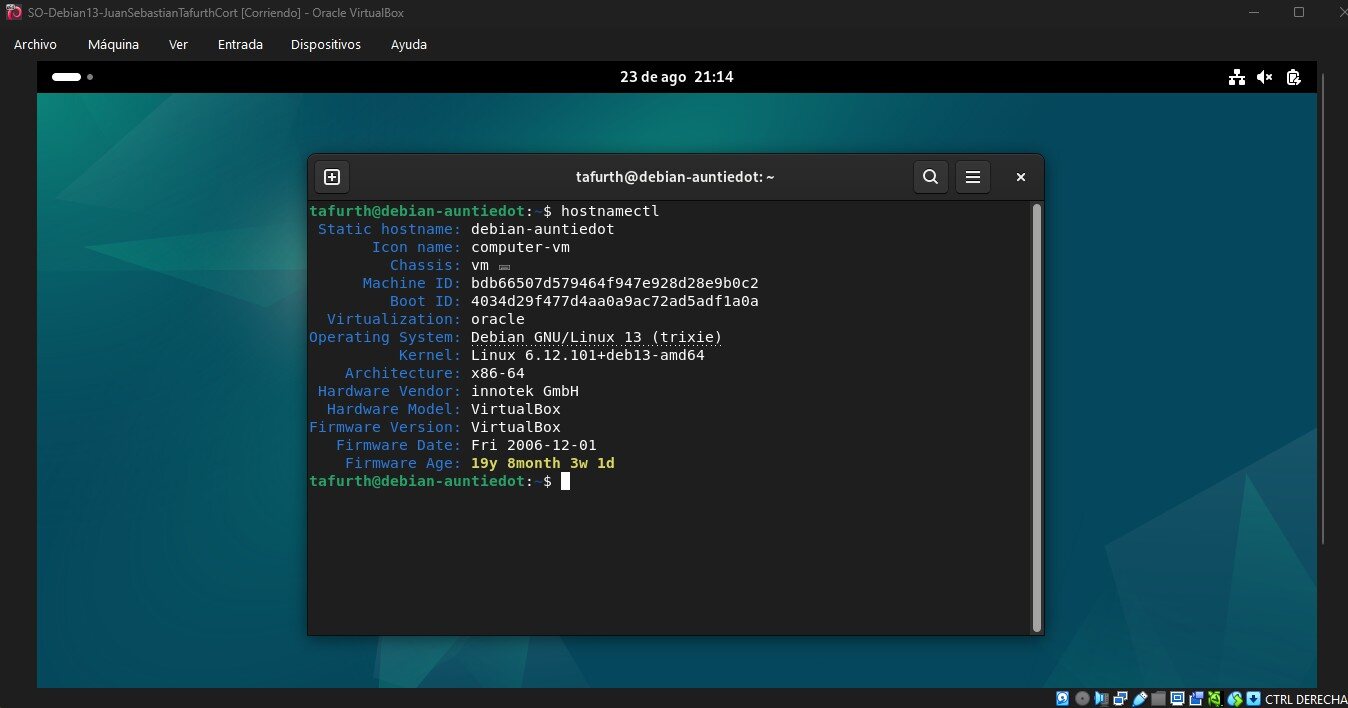
uname -a habla del kernel: Linux 6.12.101, compilado para Debian 13 y arquitectura x86_64. hostnamectl habla del sistema completo: Debian GNU/Linux 13 (trixie), el nombre debian-auntiedot, la virtualización de Oracle y el modelo de hardware VirtualBox.
Esa diferencia es la que permite decir que la distribución es el kernel más las herramientas, las bibliotecas y el escritorio que lo rodean.
$ uname -r → 6.12.101+deb13-amd64
Salida de hostnamectl en Debian
Fig. E1.2 hostnamectl
ComandoSalida realQué significa
cat /etc/os-releaseDebian GNU/Linux 13 (trixie) · 13.6Nombre, versión y codename de la distribución.
uname -r6.12.101+deb13-amd64Kernel 6.12.101 con parches de Debian 13 para amd64.
hostnamectldebian-auntiedot · Virtualization: oracle · x86-64Nombre del equipo, SO, kernel y tipo de virtualización.
lscpuIntel Core i5-1035G4 @ 1.10 GHz · 2 CPU · 1 hilo/núcleoModelo del procesador, núcleos y arquitectura.
free -hRAM 2,9 GiB · swap 1,16 GiBMemoria total, usada, disponible y área de intercambio.
lsblksda 20G · sda1 18,9G / · sda5 1,1G [SWAP]Discos, particiones, tamaños y puntos de montaje.
lspci82540EM Ethernet · SVGA II · SATA AHCIDispositivos del bus PCI: red, video y almacenamiento.
lsusb3 dispositivos · VirtualBox USB TabletDispositivos USB reconocidos por el sistema.

Lo que dejó la Parte II

  • El kernel es 6.12.101; la distribución es Debian 13.6 «trixie». No son lo mismo.
  • La VM tiene 2 vCPU del i5-1035G4 y 2,91 GiB de RAM visibles, con 1,16 GiB de swap.
  • El disco es sda de 20 GB: sda1 para el sistema y sda5 como área de intercambio.
  • El hardware es virtual: tarjeta Intel 82540EM, SVGA II y controladora SATA AHCI.
  • Estos comandos son la línea base: sin ellos no se puede comparar «antes» y «después».
Salida de lscpu
Fig. E1.3 lscpu
E2

Entrega 2 — Parte III · Unidades 3 y 4

Procesos, carga
y concurrencia.

Tres laboratorios sobre la misma VM. Primero se mira quién corre, quién lo creó y cuánto consume, y se manda un proceso a dormir o a morir. Después se mide la carga contra los dos núcleos asignados. Al final, tres scripts de Python provocan en vivo una condición de carrera, un productor-consumidor y un interbloqueo real.

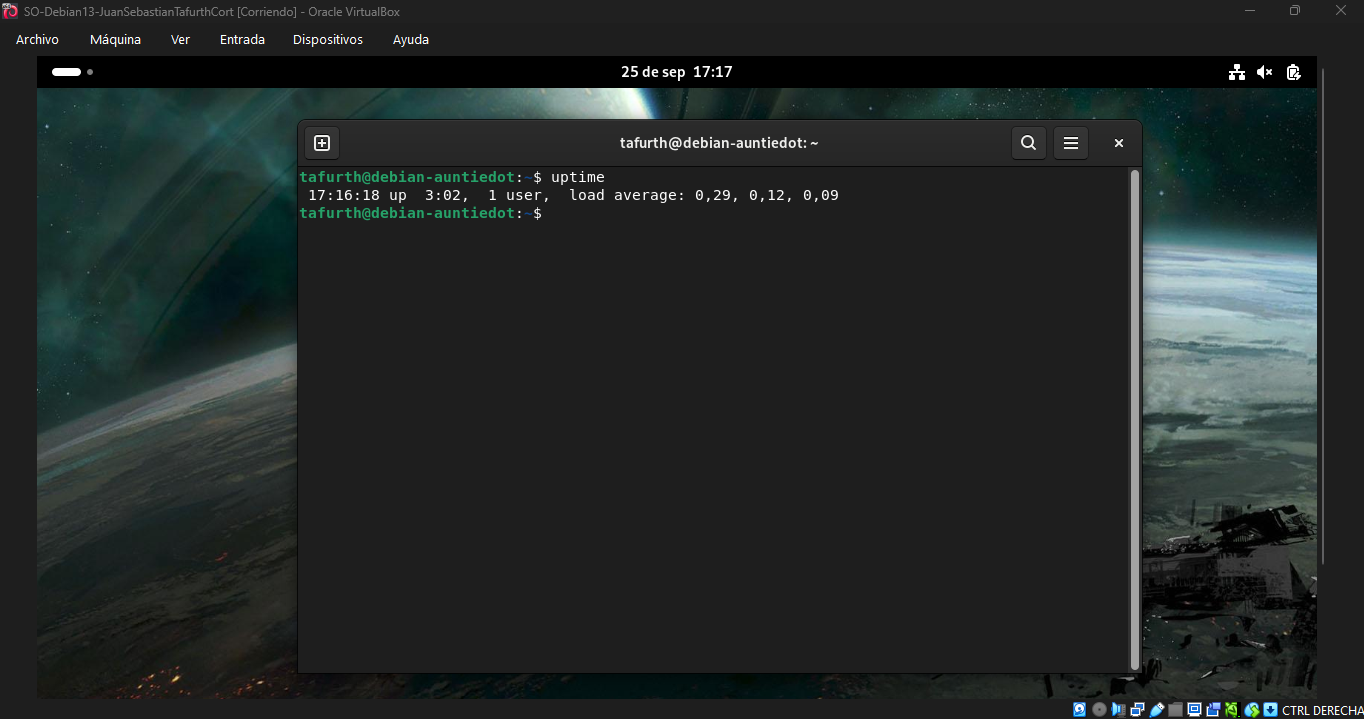
Load average · 1 min0,29procesosuptime · 17:16 · up 3:02
Núcleos asignados2vCPU2.0 = 100 % sin colas
Contador sin Lock5/ 10tres ejecuciones, mismo error
Contador con Lock10/ 10exclusión mutua correcta

Parte A · Unidad 3 — Administración real de procesos

A.1 · Quién corre y de quién cuelga

Cuatro formas de mirar lo mismo: la lista corta, la lista completa con padre e hijo, el árbol y la ficha individual de un proceso en /proc.

ps · ps -ef · pstree · cat /proc/[PID]/status

La tabla más corta y la más útil

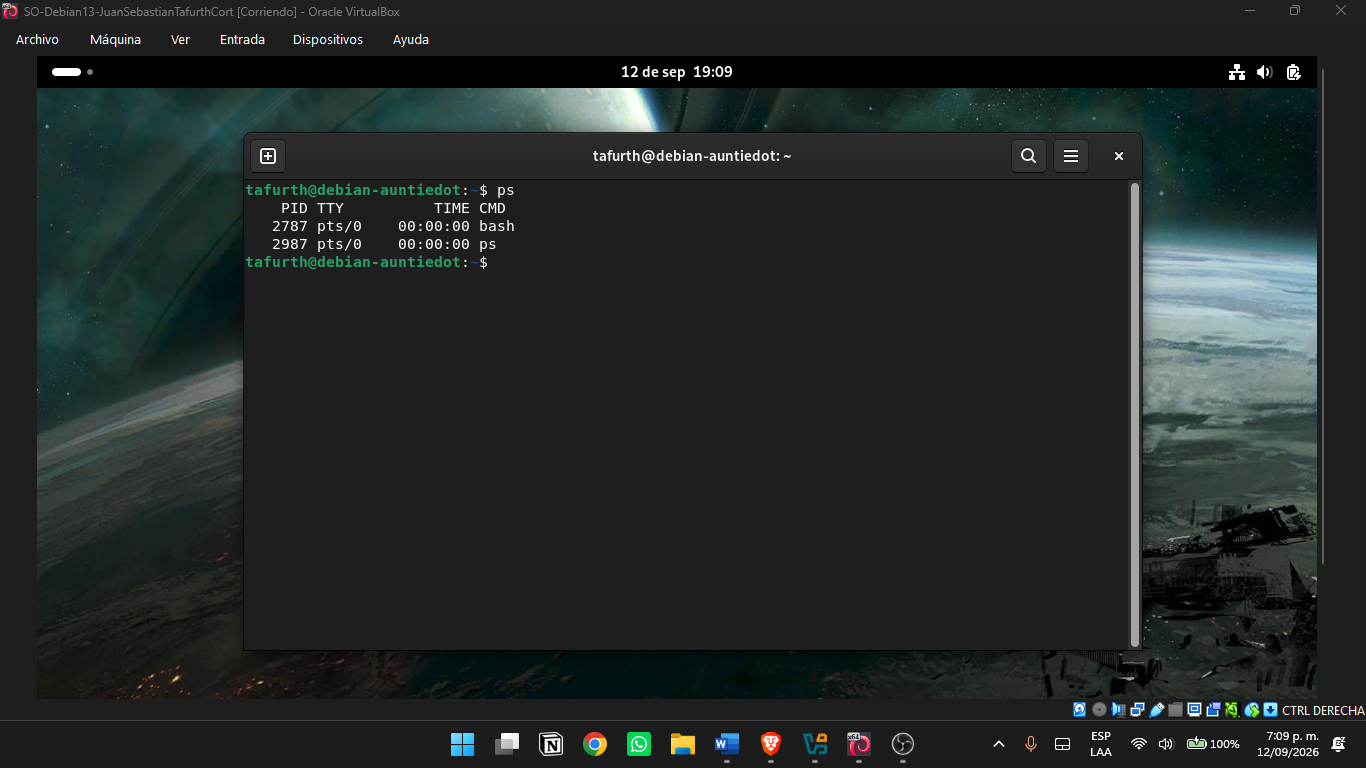
ps sin argumentos solo muestra los procesos de la terminal del usuario. En la captura aparecen dos: PID 2787 (bash, la shell) y PID 2987 (ps, el propio comando), ambos en pts/0 y con 00:00:00 de CPU acumulada.

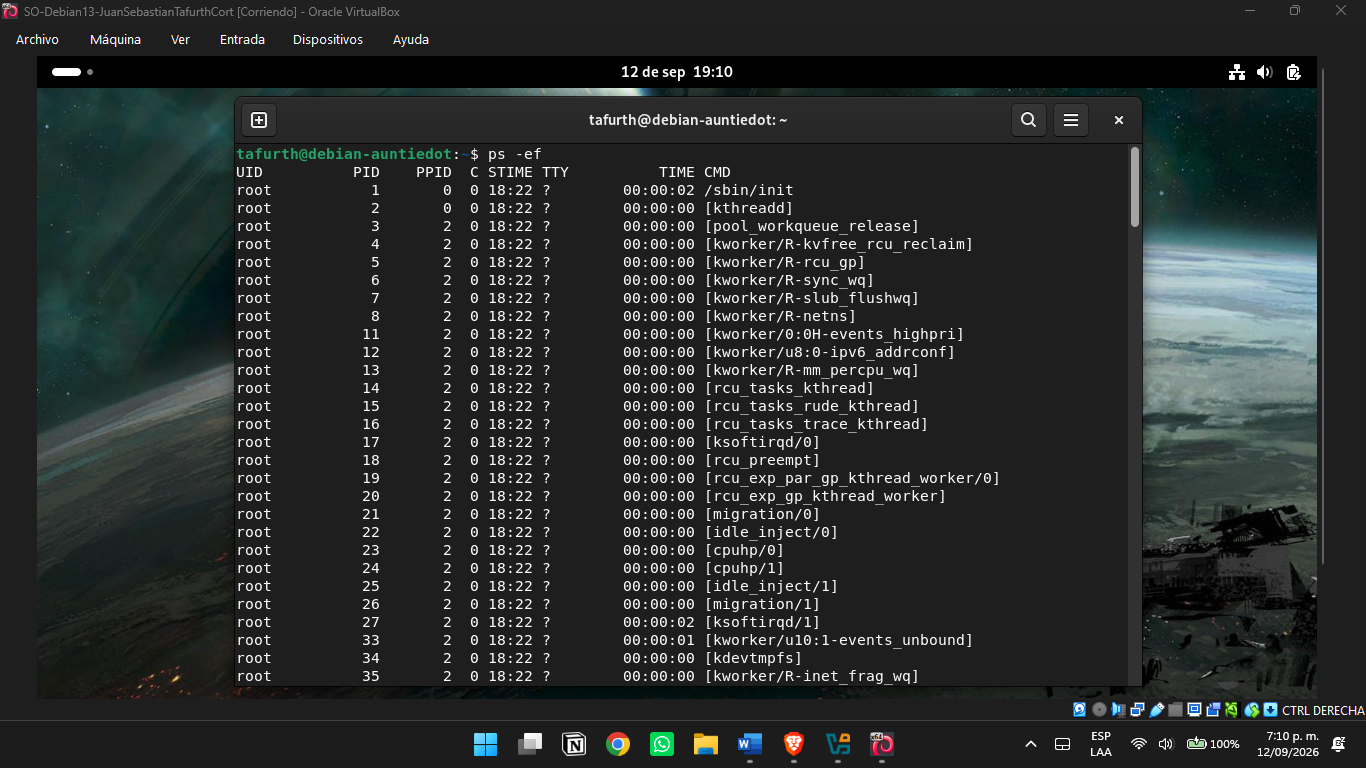
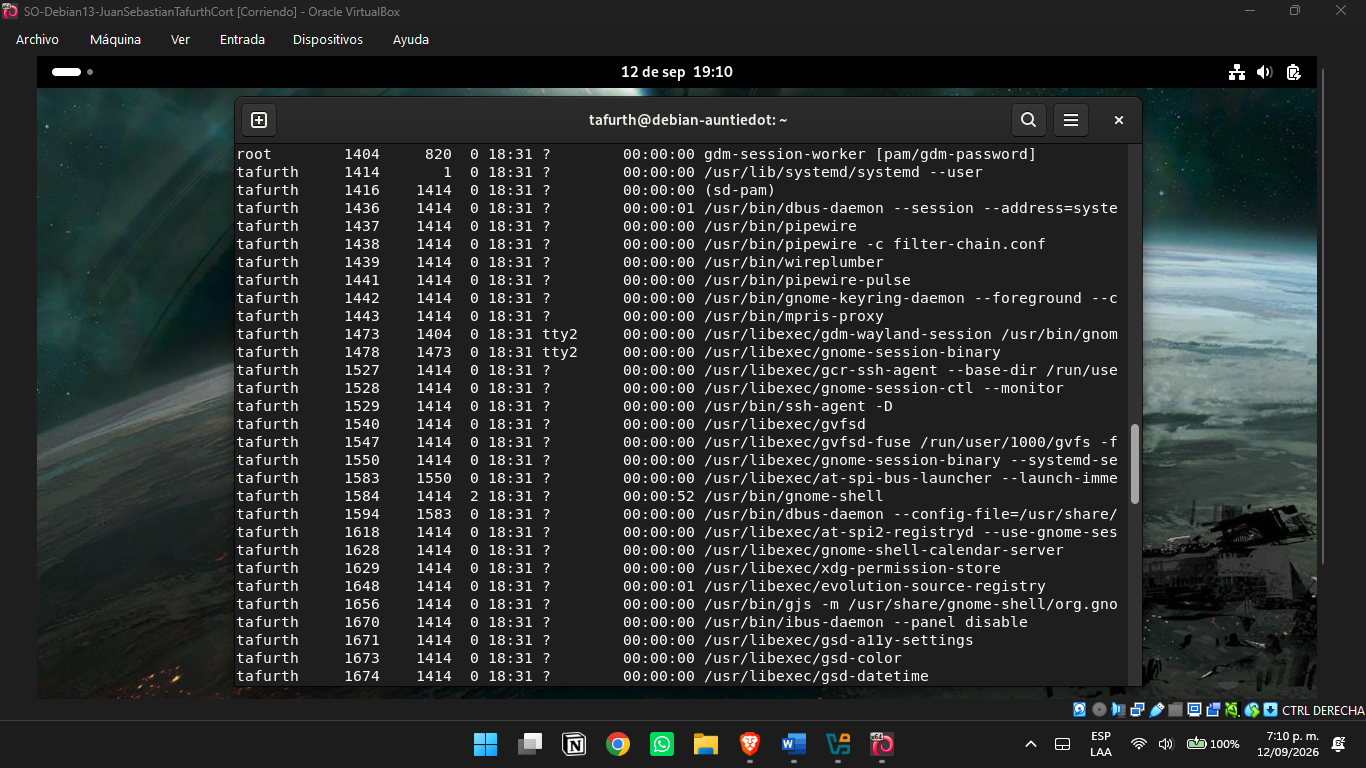
ps -ef abre el resto: añade UID, PPID, hora de inicio y el proceso padre. Ahí aparece PID 1 como /sbin/init con PPID 0 —el primero que arranca tras el kernel— y PID 1584 como gnome-shell, hijo del 1414, que es la interfaz gráfica del usuario tafurth.

$ ps → 2787 pts/0 bash · 2987 pts/0 ps
Salida del comando ps
Fig. E2.1 ps
ps -ef como root
Fig. E2.2 ps -ef · root
ps -ef como tafurth
Fig. E2.3 ps -ef · tafurth
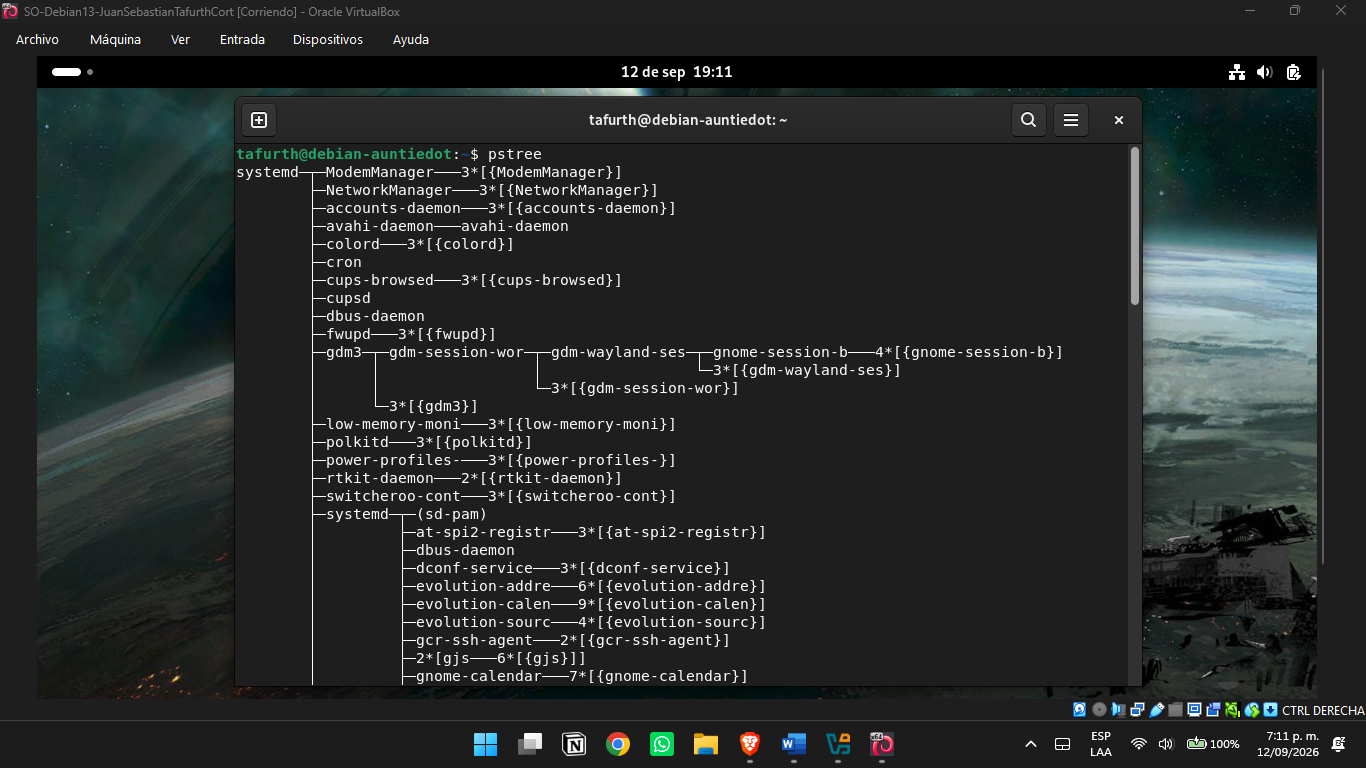
Árbol de procesos con pstree
Fig. E2.4 pstree
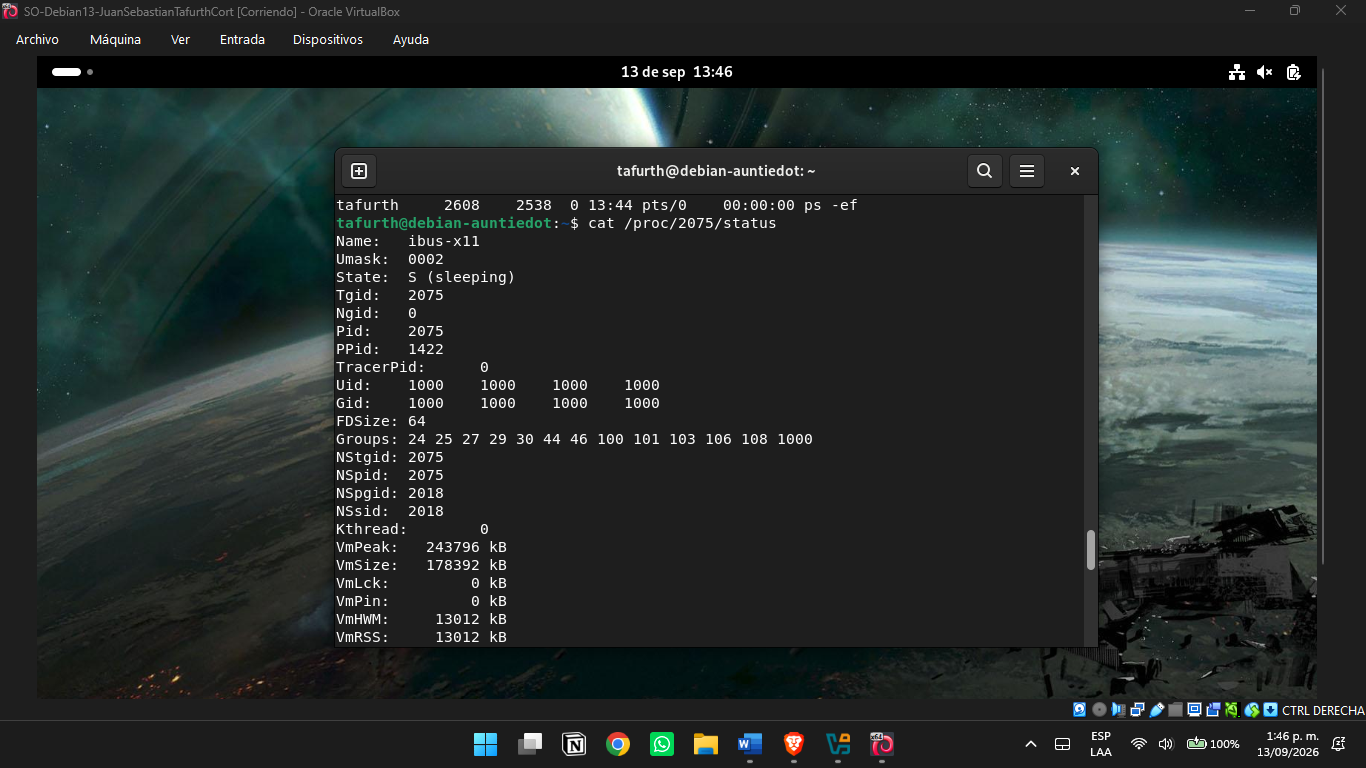
Estado de un proceso en /proc
Fig. E2.5 /proc/2075/status
ComandoSalida realQué añade
psPID · TTY · TIME · CMD → 2787 pts/0 bashSolo los procesos de la terminal del usuario.
ps -efUID · PID · PPID · C · STIME · TTY · TIME · CMDTodo el sistema, con el proceso padre de cada uno.
pstreesystemd → gdm3 · ModemManager · power-profiles-daemonLa jerarquía como árbol, desde la raíz del sistema.
cat /proc/[PID]/statusState S · VmRSS 130 212 kB · Threads 4Estado, memoria residente real y número de hilos.
PID 1

/sbin/init

El primer proceso del usuario root; PPID 0 significa que no tiene padre: lo creó el kernel.

PPID 1414

gnome-shell

PID 1584, 57 segundos de CPU y padre 1414: el escritorio también es un proceso con jerarquía.

State S

Durmiendo, no muerto

El estado S de ibus-x11 dice que espera un evento; no consume CPU mientras espera.

VmRSS

130 212 kB

Es la memoria realmente residente, no la virtual: la que ocupa páginas físicas en ese instante.

Threads 4

Cuatro hilos

Un proceso puede tener varios hilos y compartir con ellos su espacio de direcciones.

pstree

Todo cuelga de systemd

Matar un padre arrastra a sus hijos; por eso se lee el árbol antes de mandar una señal.

Parte A · Monitoreo del procesador y de los recursos

A.2 · top, htop y la carga del sistema

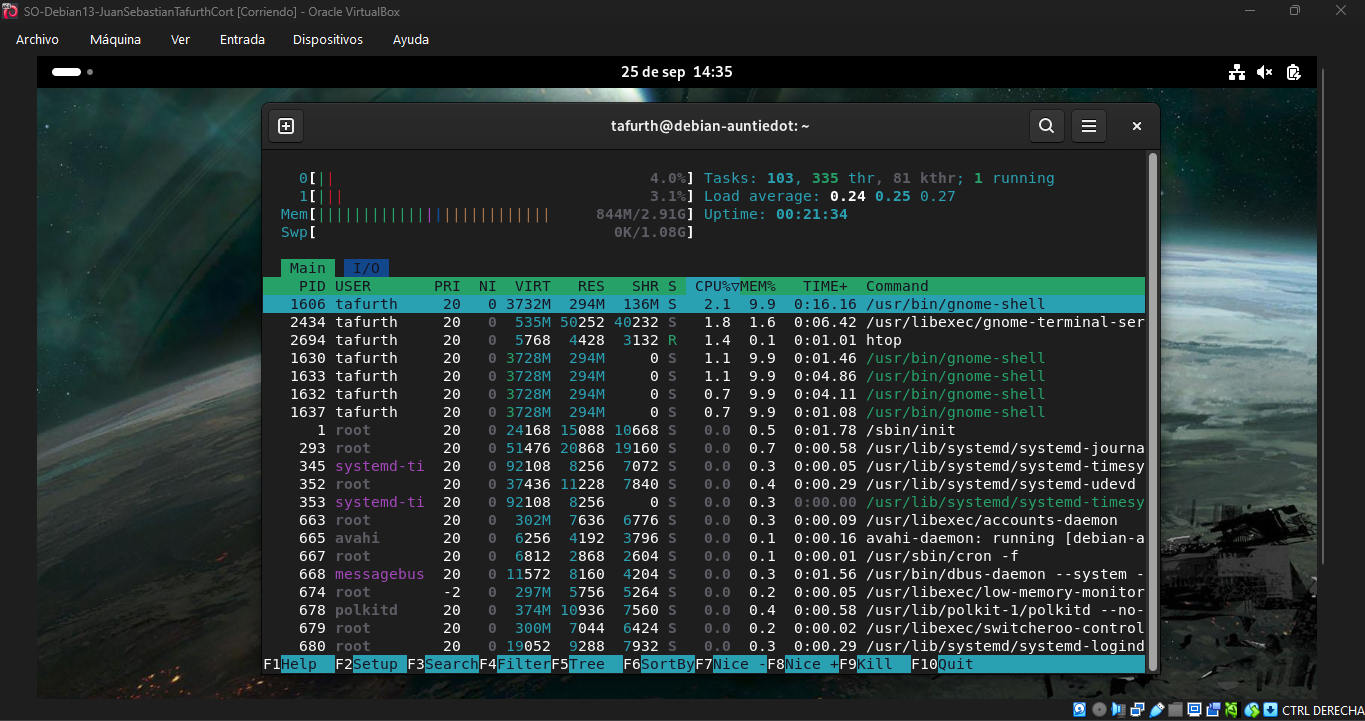
Los dos monitores leen el mismo estado del kernel y lo dibujan distinto: uno en texto plano, el otro con colores, scroll y menú de teclas. La pregunta de fondo es la misma: ¿cuántos procesos esperan CPU ahora mismo?

top vs htop

La misma foto, dos cámaras

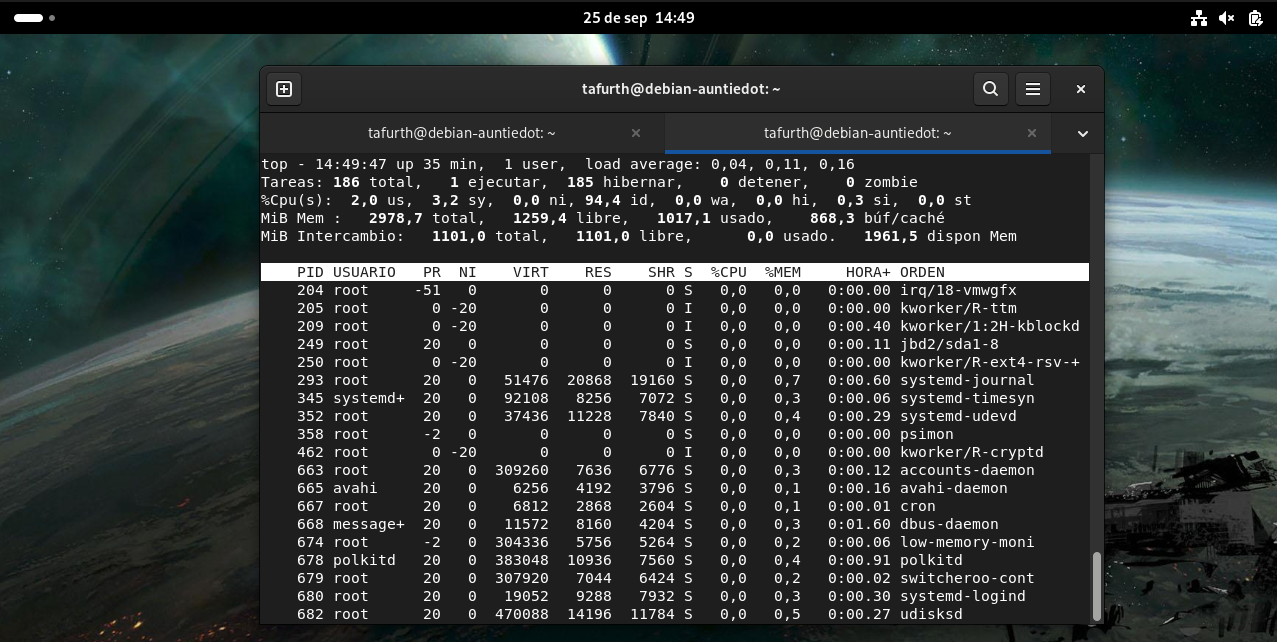
Ambos muestran PID, usuario, memoria virtual, memoria compartida, %CPU, %MEM, tiempo acumulado y comando. Al comparar proceso por proceso los valores coinciden; la única diferencia está en el tiempo transcurrido entre una captura y otra.

El caso que se documentó: el PID 293 (systemd-journal) aparece con 00:00:60 en top y 00:00:58 en htop —dos centésimas de desfase—, mientras que el PID 665 (avahi-daemon) marca 00:00:16 en los dos. No es un error de lectura: es el instante en que se tomó cada captura.

La diferencia real es de uso: htop colorea, permite desplazarse y trae un menú de teclas (F1 ayuda, F6 ordenar, F9 matar); top es más plano pero está en cualquier sistema sin instalar nada.

$ PID 293 → top 00:00:60 · htop 00:00:58
Salida de top
Fig. E2.6 top
ProcesotophtopDiferencia
PID 293 · systemd-journalVIRT 51 476 · SHR 19 160 · 0,0 %CPU · 0,7 %MEM · 00:00:60VIRT 51 476 · SHR 19 160 · 0,0 %CPU · 0,7 %MEM · 00:00:580,2 s en el tiempo de CPU
PID 665 · avahi-daemonVIRT 6 256 · SHR 4 192 · 0,0 %CPU · 0,1 %MEM · 00:00:16VIRT 6 256 · SHR 4 192 · 0,0 %CPU · 0,1 %MEM · 00:00:16Ninguna: coinciden todos los valores

uptime · load average

¿Cuándo una carga es alta?

uptime devolvió la hora (17:16:18), el tiempo encendido (3:02), un usuario conectado y los tres valores de carga media: 0,29 en el último minuto, 0,12 en los cinco últimos y 0,09 en los quince. La carga venía subiendo.

El número solo se interpreta contra los núcleos. A la VM se le asignaron 2 de los 4 núcleos del equipo, así que una carga de 2.0 es el 100 % de la capacidad recomendada: por encima de eso empiezan las colas de espera. Con 0,29 el sistema estaba al 14,5 % de esa capacidad.

$ 0,29 / 2 núcleos → 14,5 % · el límite es 2.0
Salida de uptime
Fig. E2.7 uptime
Interfaz de htop
Fig. E2.8 htop

Parte A · Señales y prioridad

A.3 · Terminar con orden o con fuerza

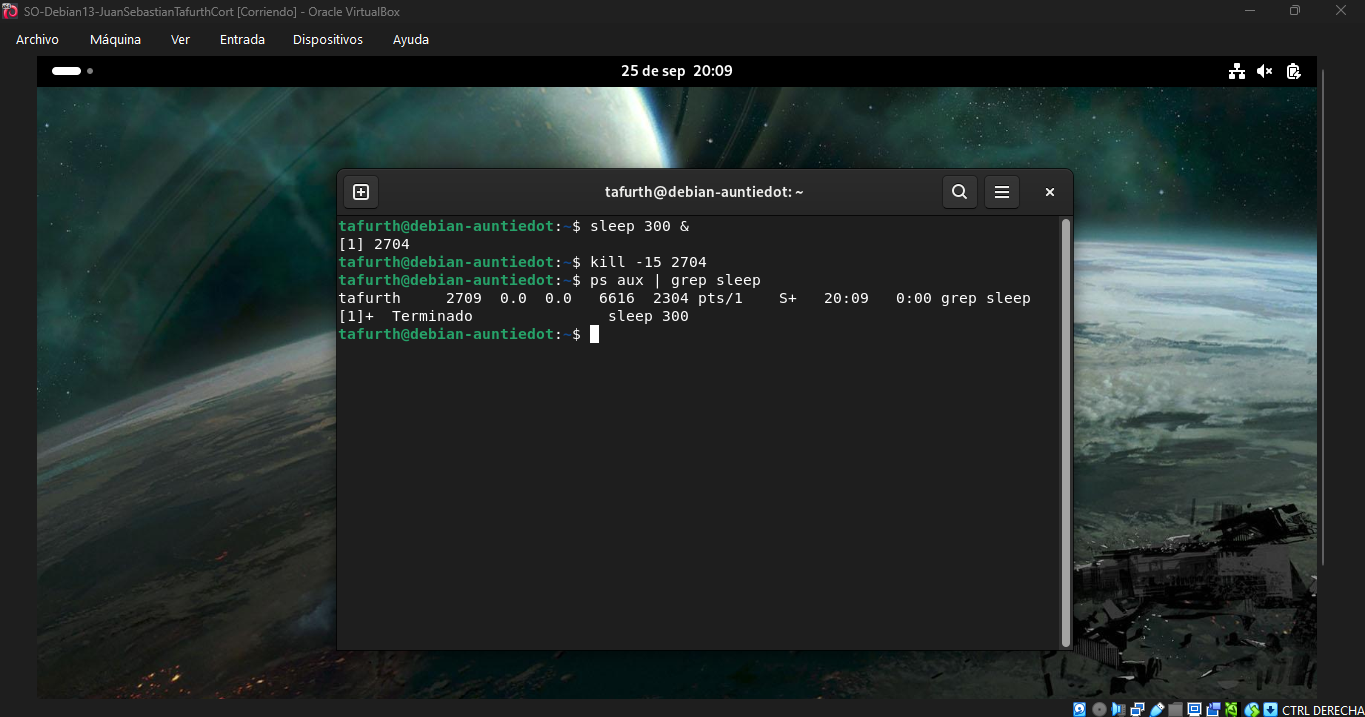
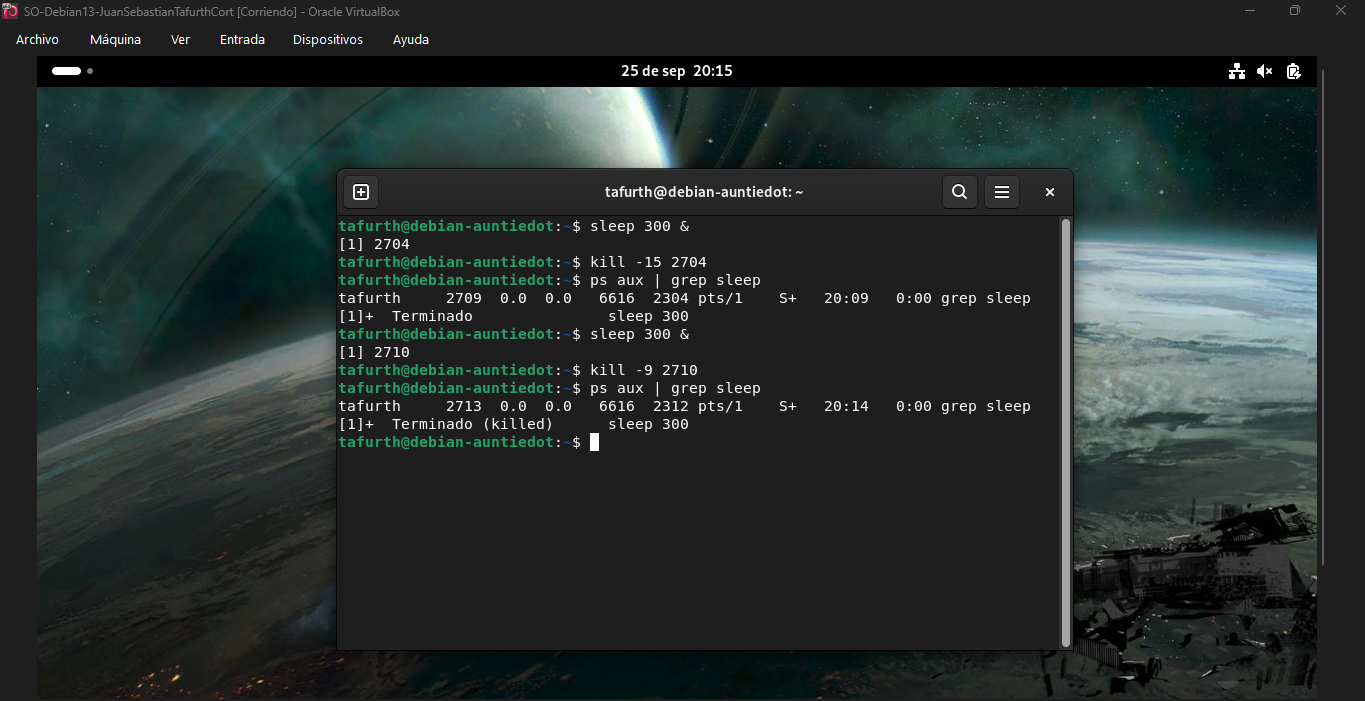
Un proceso se puede pedir que se vaya (SIGTERM) o se puede destruir desde el kernel (SIGKILL). Y se le puede dar más o menos CPU con nice y renice.

Los pasos que se ejecutaron

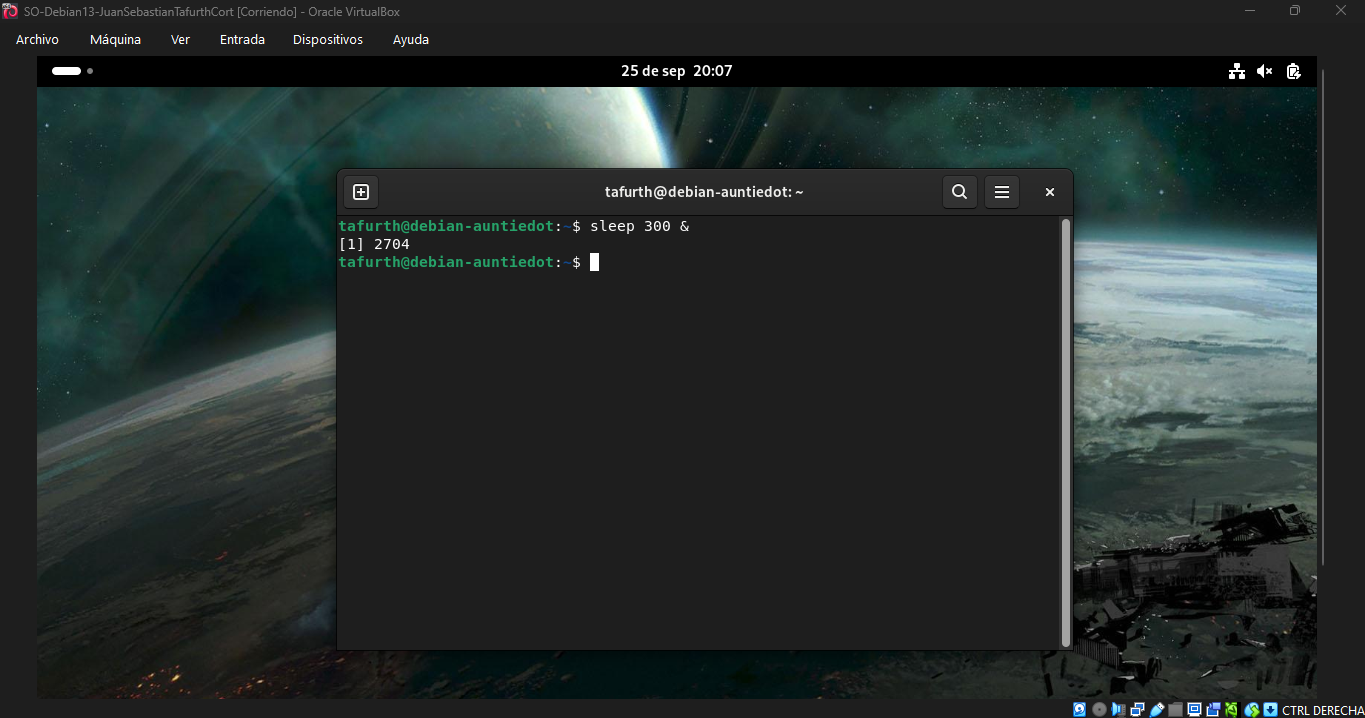
  1. sleep 300 & → PID 2704 en segundo plano
  2. ps aux | grep sleep → confirmar que sigue vivo
  3. kill -15 2704 → SIGTERM, cierre ordenado
  4. Repetir y kill -9 2704 → SIGKILL, sin limpieza
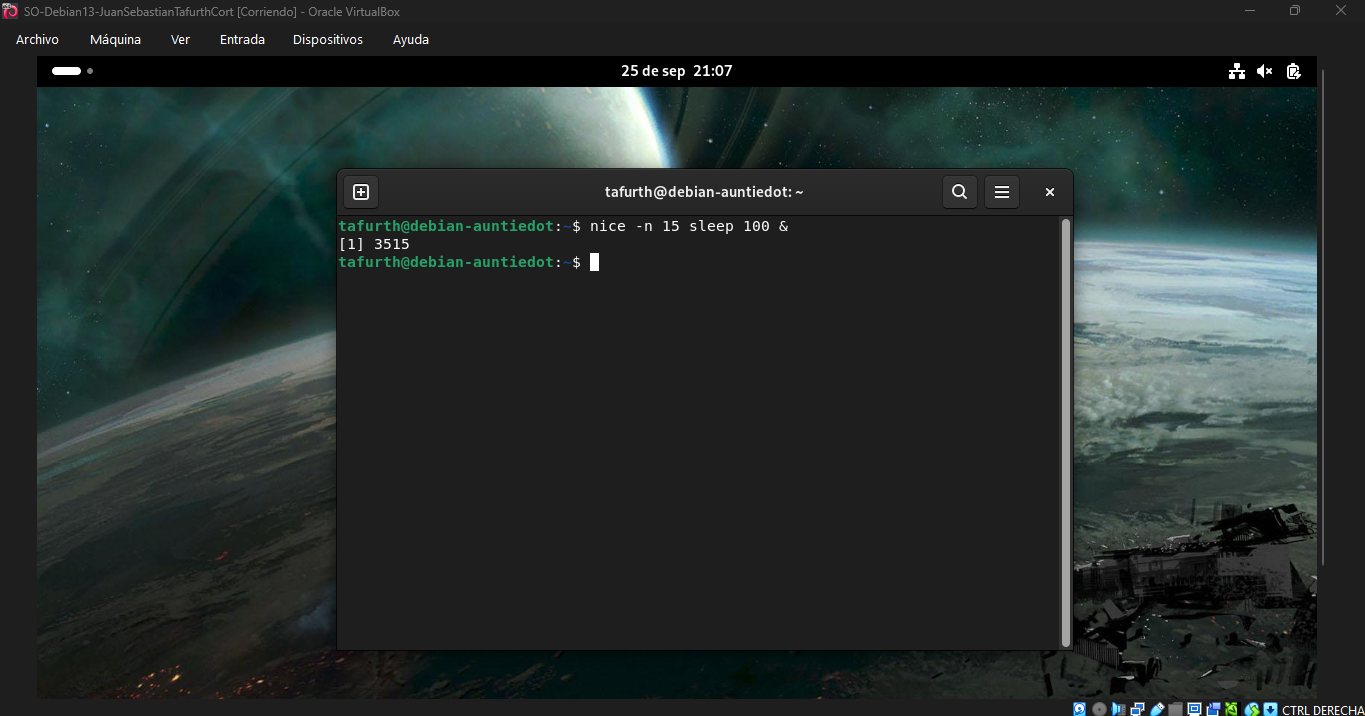
  5. nice -n 15 sleep 100 & → PID 3493
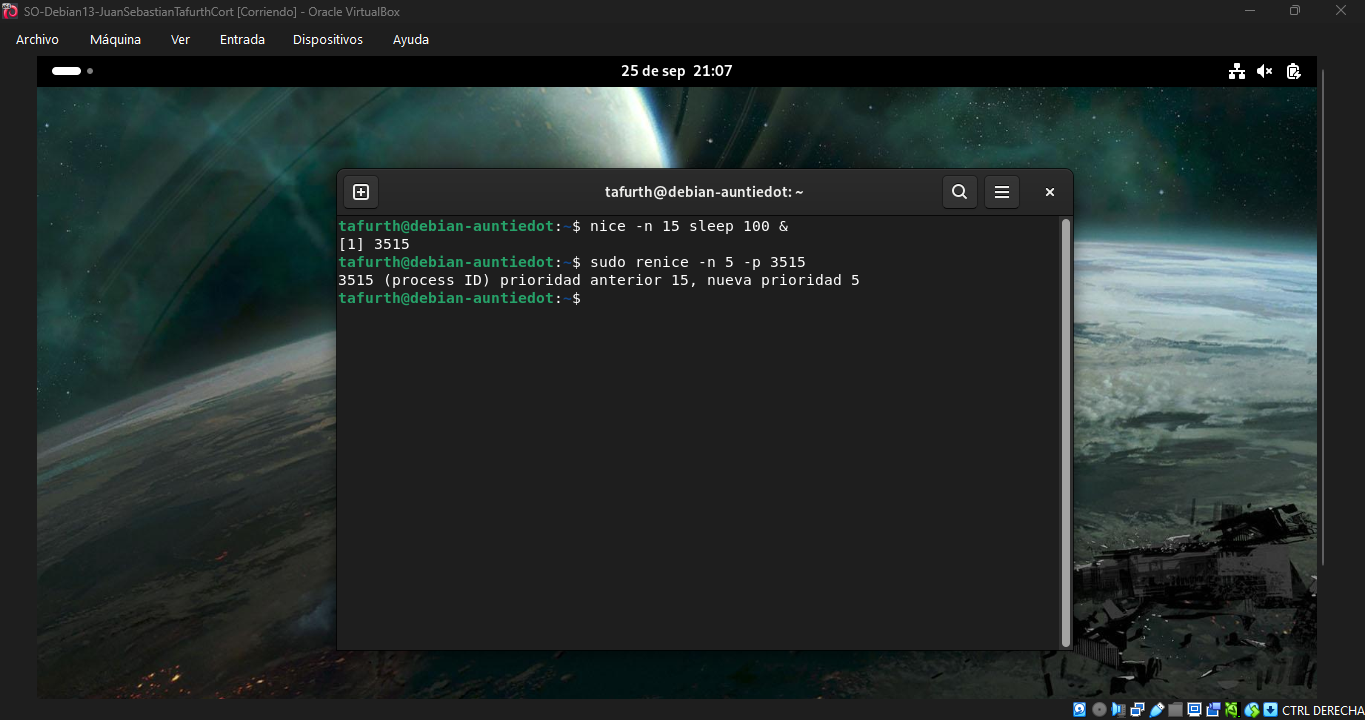
  6. sudo renice -n 5 -p 3493 → subir prioridad
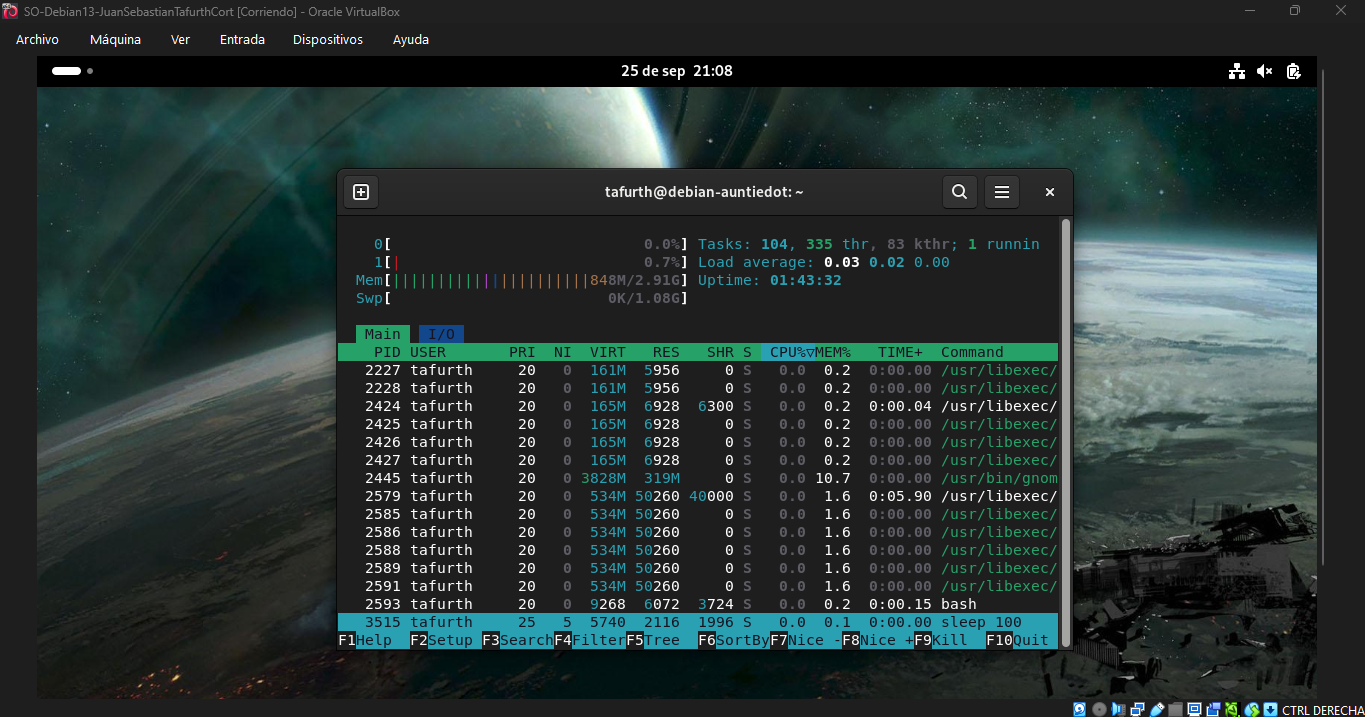
  7. Verificar el nuevo valor en htop
La trampa

Por qué renice necesita sudo

Un usuario normal solo puede bajar la prioridad de sus procesos: aumentar el número nice (de 0 a 15, por ejemplo). Subirla —bajar el número, de 15 a 5— es un privilegio del administrador, porque permitiría acaparar la CPU.

Sin sudo, la terminal rechaza la operación. Con sudo se aplicó el cambio de 15 a 5 sobre el PID 3493 y se comprobó en htop, donde el proceso apareció al final de la lista con su nuevo valor.

sleep en segundo plano
Fig. E2.9 PID 2704
kill -15
Fig. E2.10 kill -15
kill -9
Fig. E2.11 kill -9
nice -n 15
Fig. E2.12 nice 15
sudo renice
Fig. E2.13 renice 5
Verificación en htop
Fig. E2.14 comprobación

Parte B · Unidad 4 — Laboratorio experimental de concurrencia

B.1 · Condición de carrera

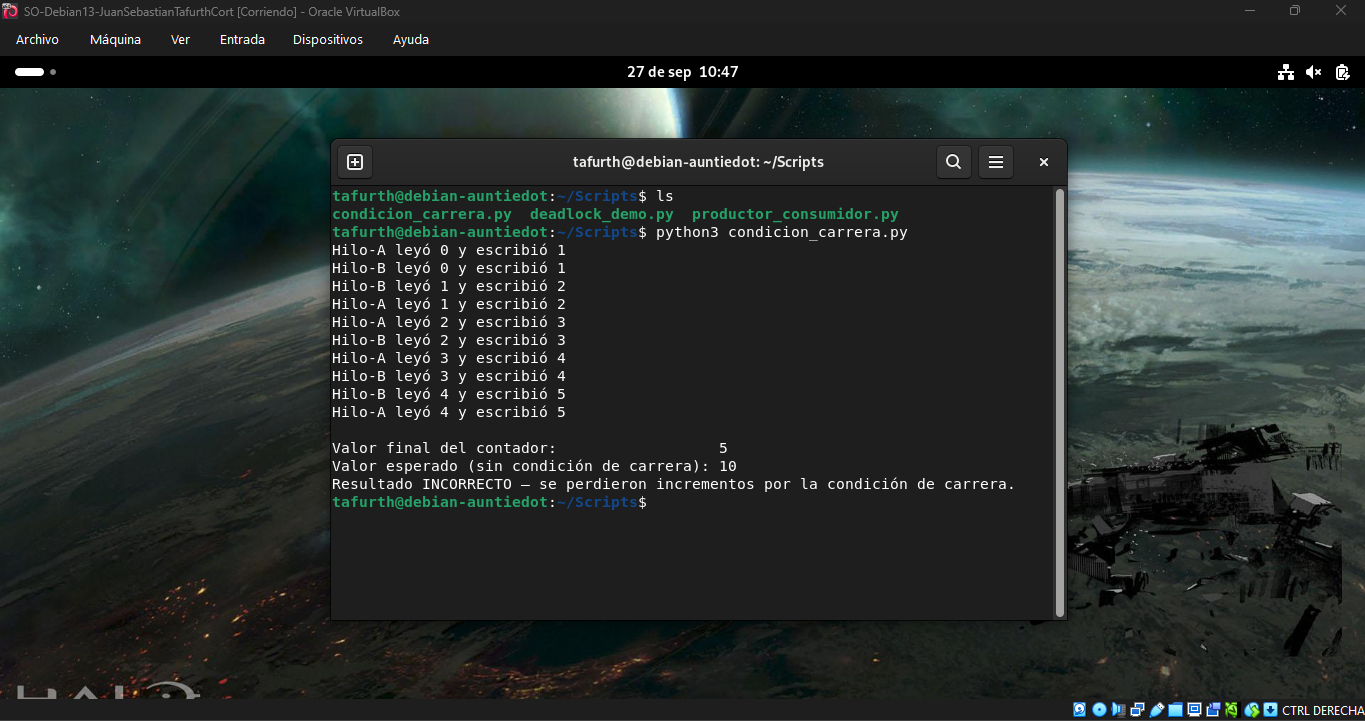
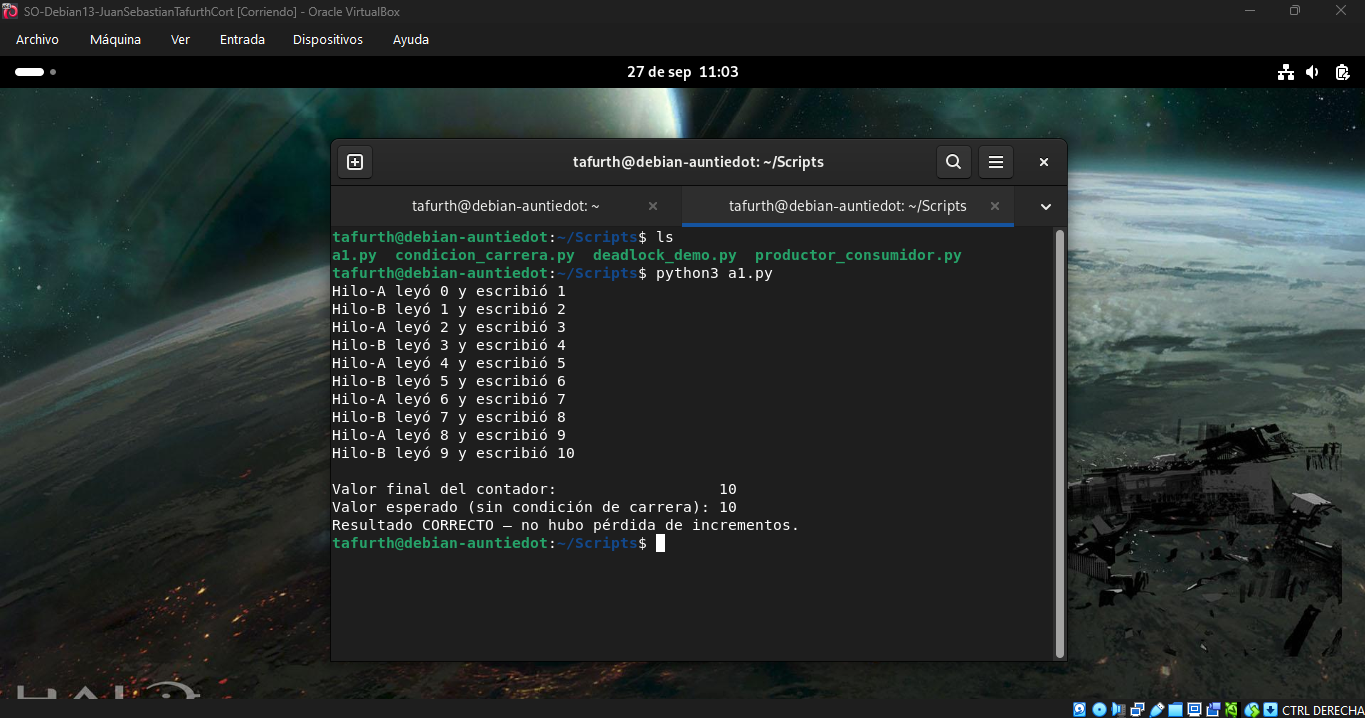
Dos hilos incrementan el mismo contador cinco veces cada uno. Sin protección el resultado es 5; con un Lock, 10. La diferencia son diez incrementos que existieron y se perdieron.

condicion_carrera.py

Dos hilos, un contador y un valor viejo

El script lanza dos hilos (Hilo-A y Hilo-B) que leen la variable valor_leído, le suman 1 y la escriben de nuevo. Se ejecutó tres veces sin protección y las tres dieron lo mismo: contador 5 cuando debía ser 10.

El motivo es que ambos hilos leen el mismo valor original antes de que el otro escriba. Si A lee 3 y B lee 3, los dos escriben 4: uno de los dos incrementos se pierde. Al activar el Lock, solo un hilo entra a la vez en la región crítica, el segundo lee el valor ya actualizado y el contador llega a 10.

$ sin Lock → 5 · con Lock → 10 · esperado 10
Condición de carrera sin protección
Fig. E2.15 sin Lock · 5
EscenarioQué se predijoQué pasó realmentePor qué
Sin protecciónCada hilo suma 1 cinco veces: el contador debería llegar a 10.Tres ejecuciones seguidas terminaron en 5, con la etiqueta INCORRECTO.Ambos hilos leen el valor original y escriben el mismo resultado; los incrementos se pisan.
Con LockLa exclusión mutua obliga a esperar, así que el resultado debe ser 10.Contador 10, etiqueta CORRECTO.Solo un hilo modifica la variable a la vez y el siguiente lee el valor ya actualizado.

La misma prueba, con exclusión mutua

El candado que ordena la fila

Con el Lock activo la salida ya no muestra lecturas repetidas: cada línea lee el valor que dejó la anterior (0→1, 1→2, 2→3…) hasta llegar a 10. El candado no hace que los hilos vayan más rápido; hace que no se pisen.

Ese es el coste real de la sincronización: se gana corrección, se pierde paralelismo.

Condición de carrera con Lock
Fig. E2.16 con Lock · 10

Parte B · Productor-consumidor

B.2 · Tres semáforos y un búfer

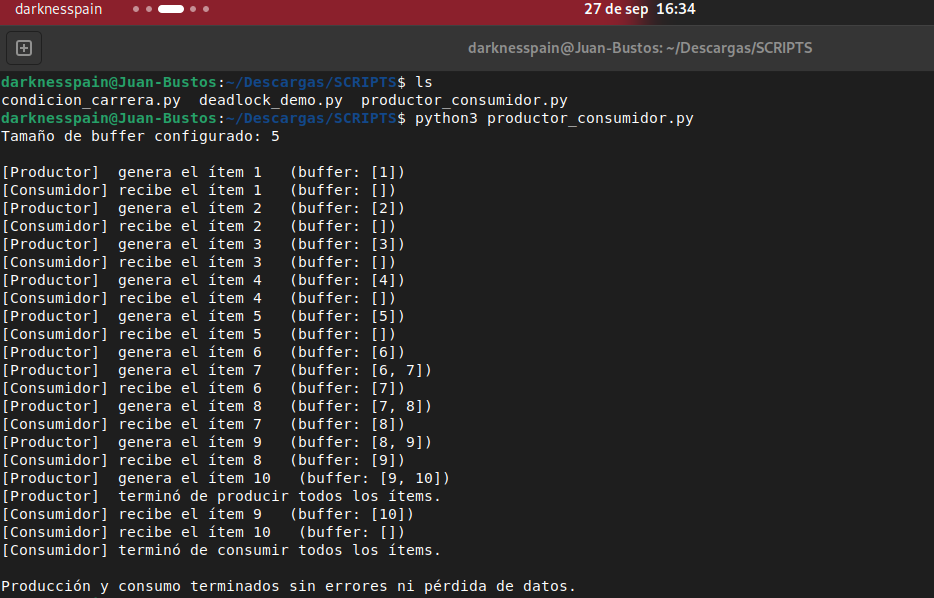
Un hilo produce y otro consume. El tamaño del búfer decide si trabajan a su propio ritmo o si están obligados a turnarse.

Los tres semáforos

mutexbinario · exclusión mutua del búfer
espacios_libresinicia en TAMANO_BUFFER
elementos_disponiblesinicia en 0

El productor espera si no hay espacio; el consumidor espera si no hay elementos. El mutex solo protege la sección crítica donde se toca el arreglo compartido.

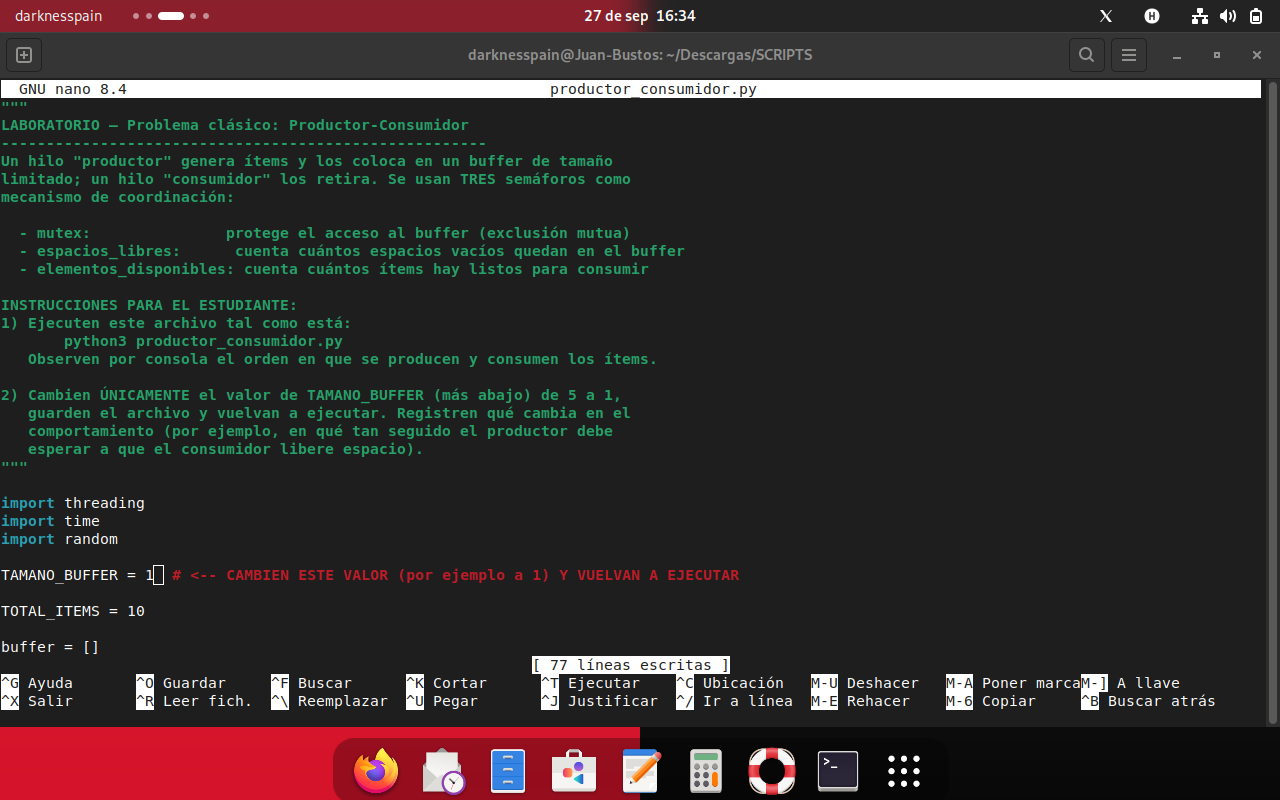
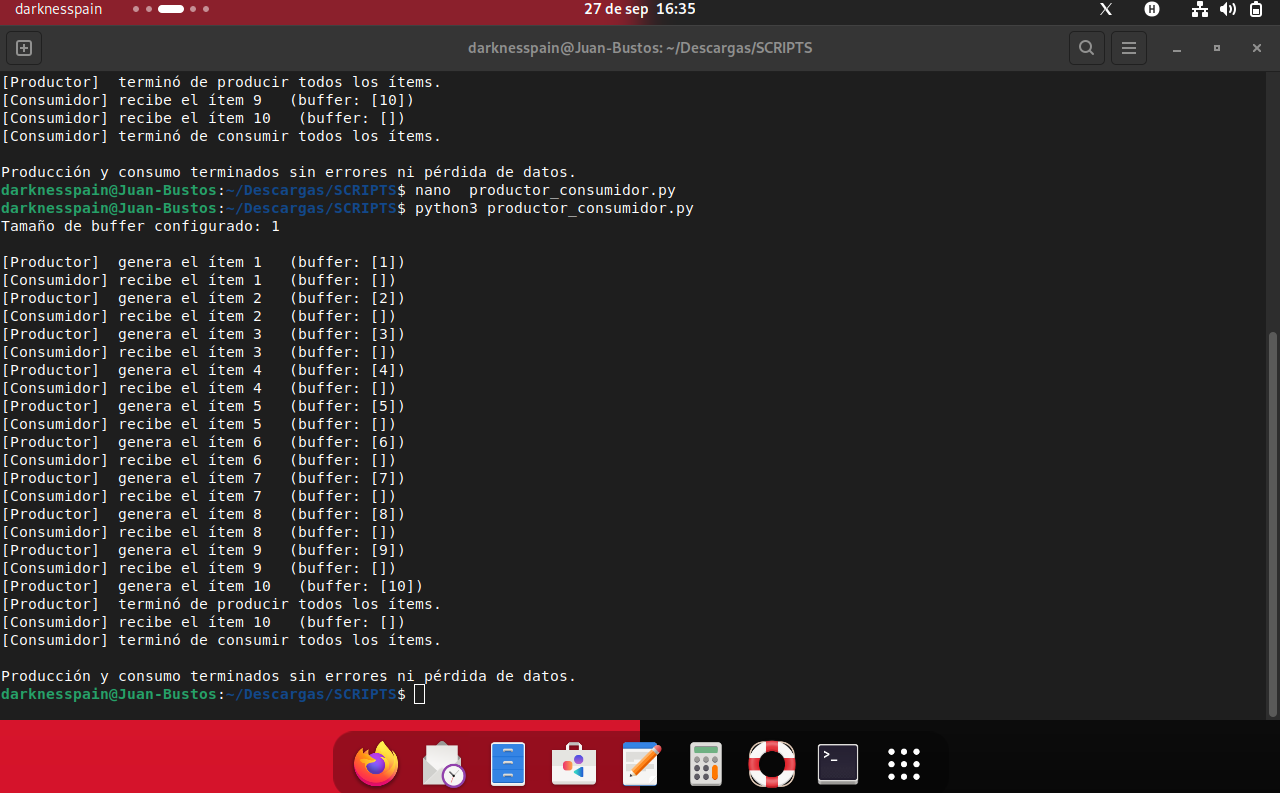
Búfer 5 contra búfer 1

  • Con 5, el productor mete varios ítems seguidos antes de bloquearse: los hilos quedan desacoplados y el flujo es asíncrono.
  • Con 1, cada ítem llena el búfer y el productor espera a que lo retiren: alternancia estricta, como un pasamanos.
  • En ninguno de los dos casos se perdió un dato: el mutex protegió el búfer.
Búfer de 5
Fig. E2.17 búfer 5
Edición del búfer en nano
Fig. E2.18 nano · buffer 1
Búfer de 1
Fig. E2.19 búfer 1

Parte B · Interbloqueo

B.3 · Havender en vivo

Dos hilos y dos recursos: una impresora y un escáner, cada uno con su Lock. Pedirlos en orden distinto congela el programa; pedirlos en el mismo orden lo salva.

1

Exclusión mutua

La impresora y el escáner son threading.Lock(): mientras un hilo lo tiene, nadie más puede usarlo.

2

Retención y espera

El Hilo A toma la impresora, duerme un segundo y pide el escáner sin soltar lo que ya tiene.

3

No expropiación

Nada le quita el recurso a la fuerza: solo lo libera quien lo tomó, con release().

4

Espera circular

A espera el escáner de B y B espera la impresora de A. El círculo se cierra y nadie avanza.

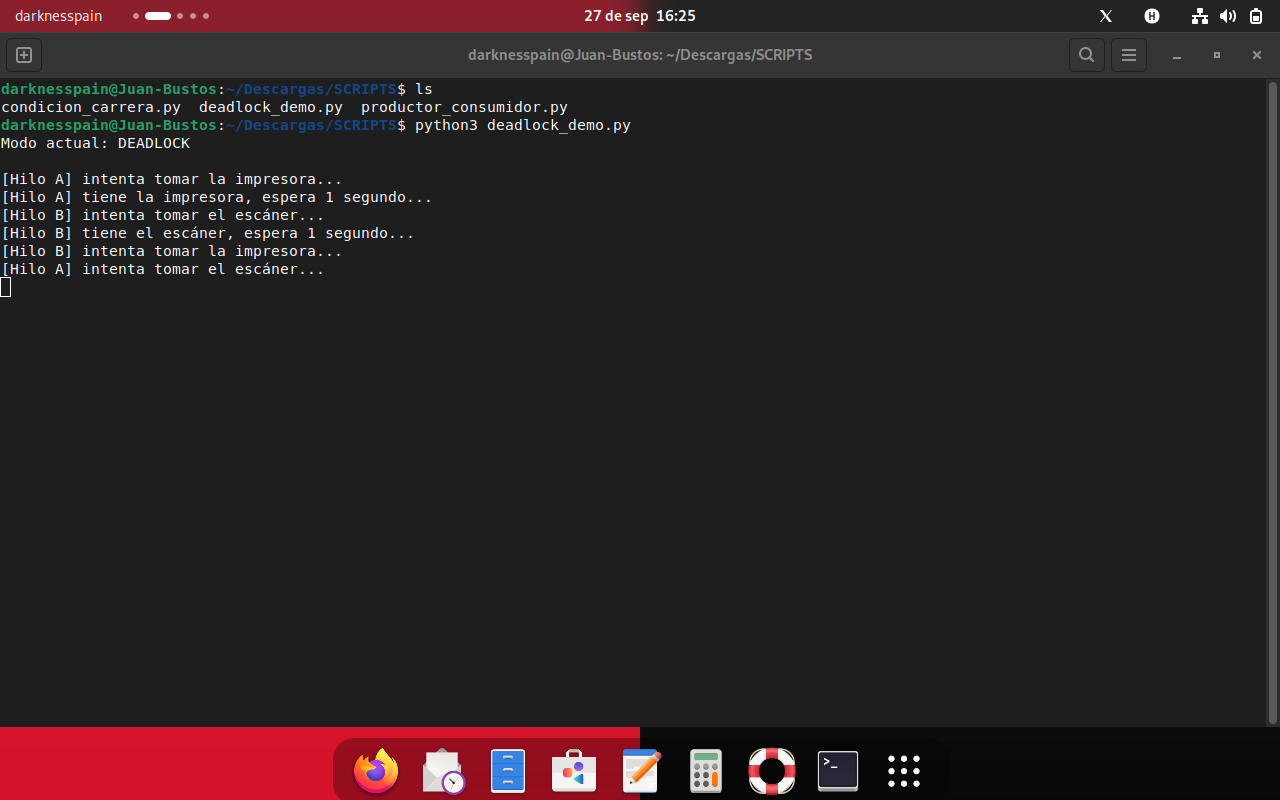
MODO = "DEADLOCK"

El programa se queda colgado

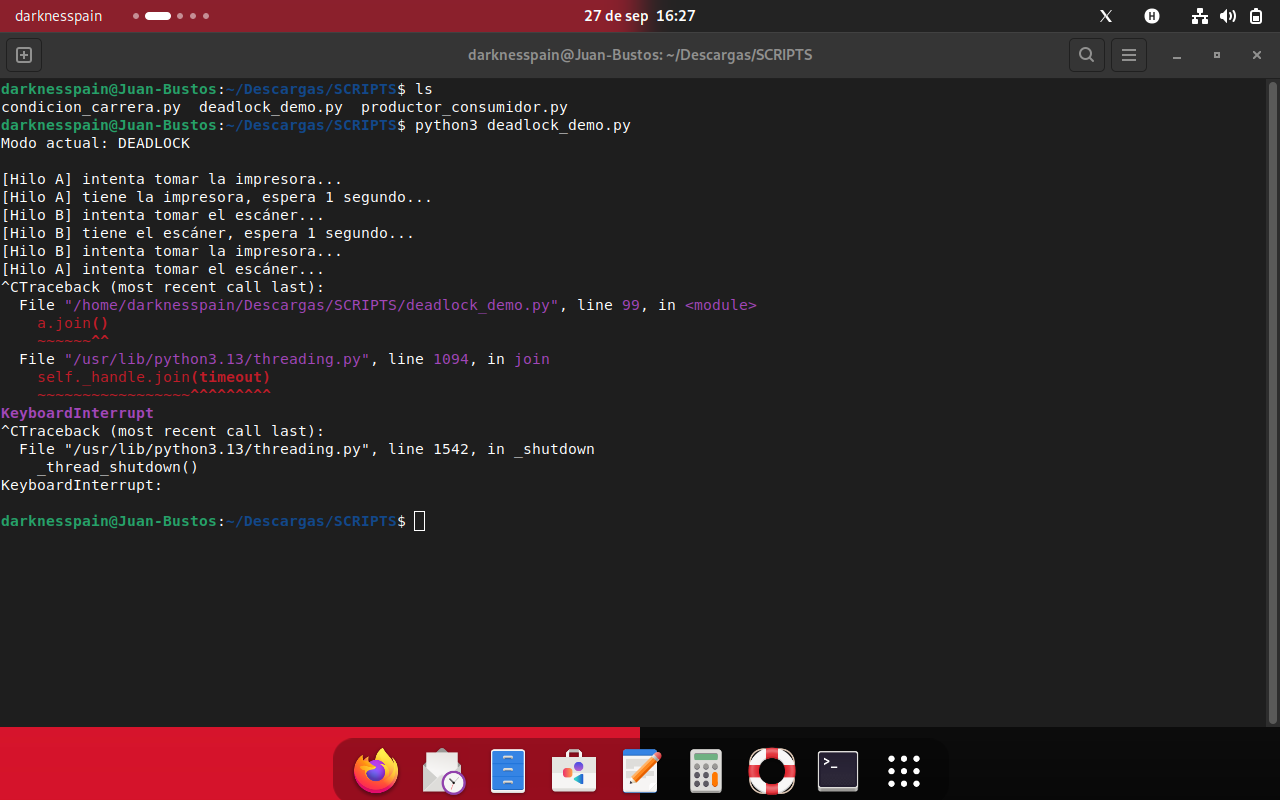
La salida muestra las adquisiciones parciales —[Hilo A] tiene la impresora, [Hilo B] tiene el escáner— y después nada más. Tras 15 segundos sin avanzar hubo que interrumpirlo con Ctrl+C, y la traza mostró KeyboardInterrupt en el join().

Se cumplían las cuatro condiciones de Havender al mismo tiempo: por eso el bloqueo era inevitable.

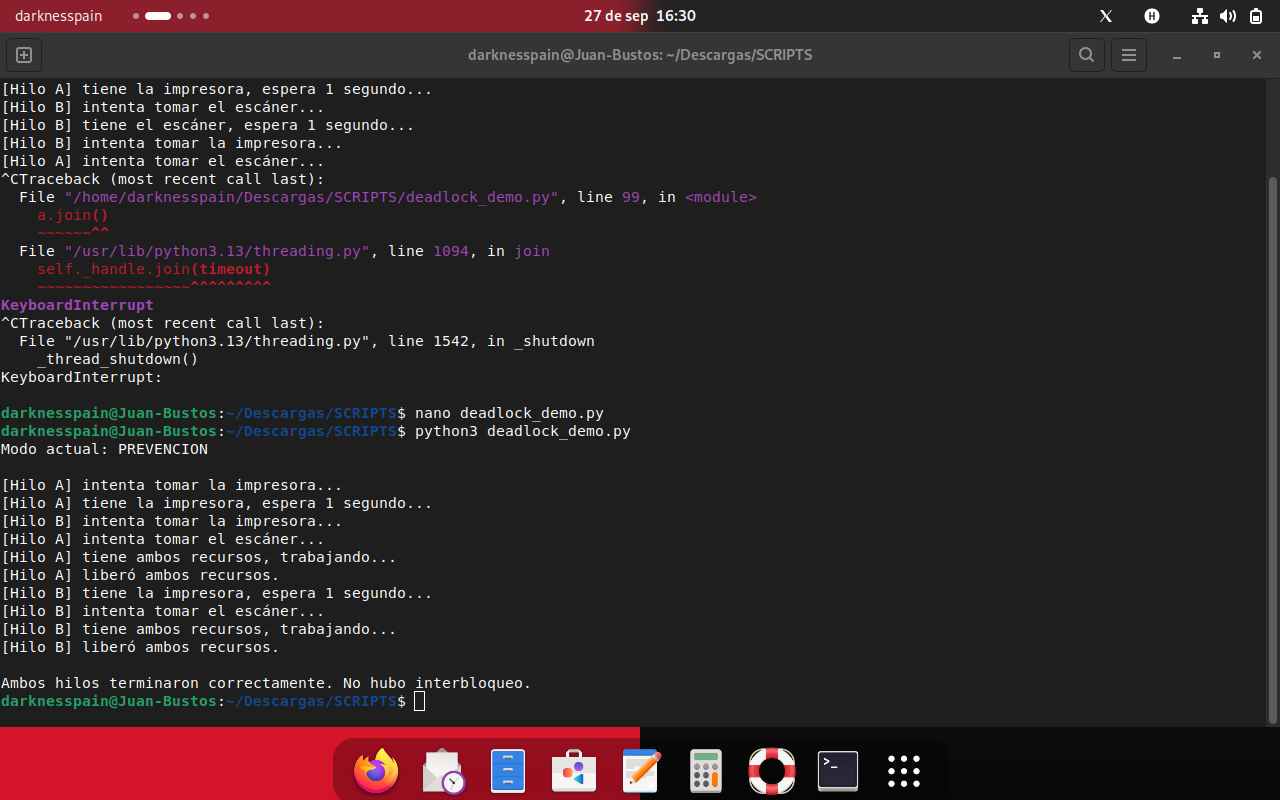
MODO = "PREVENCION"

Un solo orden y se rompe el círculo

Ambos hilos piden primero la impresora y después el escáner. Si el Hilo B no consigue la impresora, no puede quedarse con el escáner: la espera circular desaparece.

El programa terminó sin trabarse, con el mensaje final «Ambos hilos terminaron correctamente. No hubo interbloqueo.» Bastó romper una de las cuatro condiciones.

Interbloqueo
Fig. E2.20 deadlock
Ctrl+C sobre el interbloqueo
Fig. E2.21 Ctrl+C
Prevención del interbloqueo
Fig. E2.22 prevención

Cierre del laboratorio

Cinco preguntas que quedan

Las respuestas que se discutieron al terminar la práctica.

Sin un orden de ejecución definido, los dos hilos leen y modifican la variable casi al mismo tiempo. Cada uno toma el valor inicial y, cuando el primero escribe, el segundo ya leyó el viejo: incrementa sobre datos desactualizados. Con la protección, un hilo entra a la vez en la región crítica y el siguiente lee el valor ya actualizado, así que el resultado se repite siempre y es correcto.

No habría espacio intermedio: el productor no podría dejar el dato y irse a producir otro. Se volvería un rendezvous o cita previa, un punto de transferencia estricto mano a mano. La región crítica dejaría de ser un depósito y pasaría a exigir que ambos hilos coincidan en el tiempo: si el consumidor se demora, el productor se congela; si el productor se retrasa, el consumidor no tiene nada que hacer.

La espera circular. Imponer un orden jerárquico global —primero impresora, después escáner— hace imposible el ciclo: si A tiene la impresora, B no puede adueñarse del escáner y esperar la impresora. Bastó una porque Havender exige las cuatro a la vez: romper una sola ya impide el interbloqueo.

Linux agrupa estados que en teoría van separados. R cubre Listo y Ejecutando: para el planificador ambos están runnable. S (y D) es el Bloqueado o En espera: el proceso no gasta CPU porque aguarda un teclado, un sleep, un paquete o el disco. Z es el Terminado que aún no fue recogido por su padre con wait(). El estado Nuevo es el instante del fork(), antes de entrar a la cola de listos.

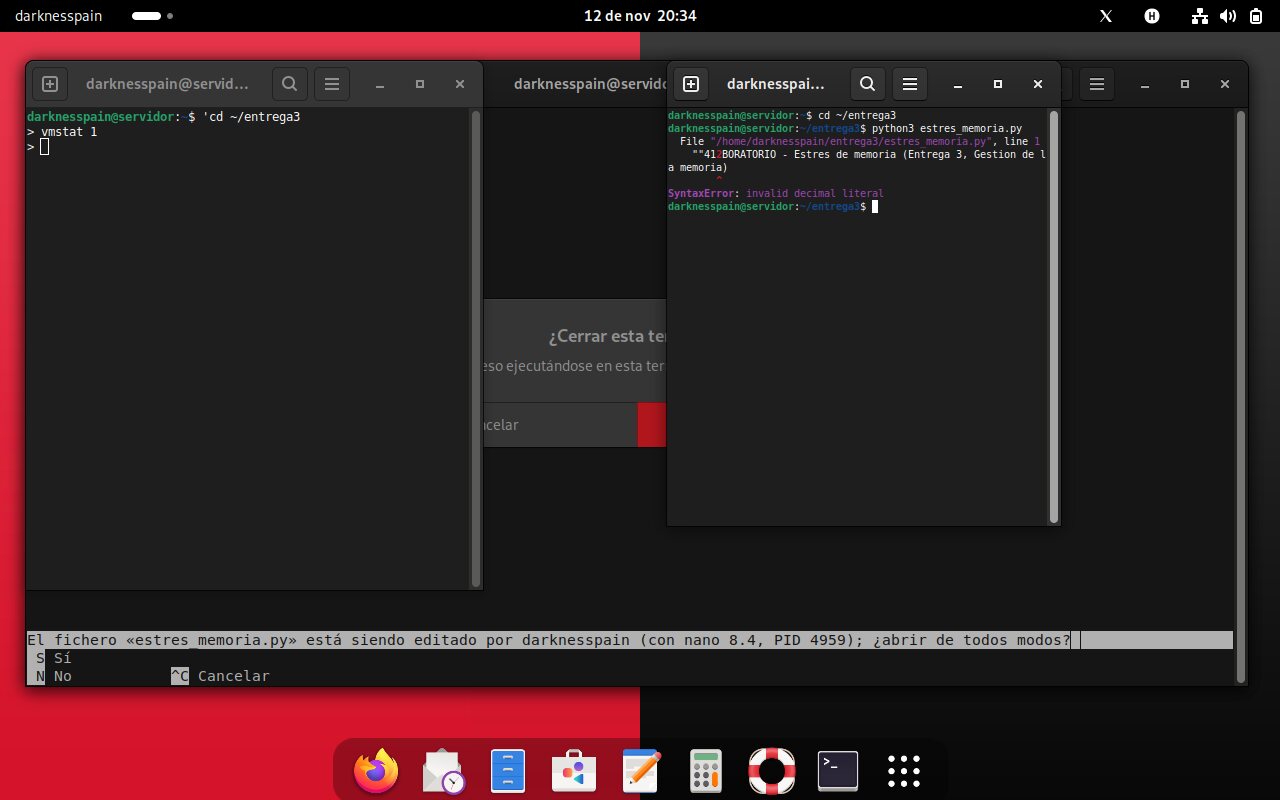
Tres cosas. Filtrar procesos en segundo plano: con & no es evidente si siguen vivos, así que hubo que apoyarse en ps aux | grep sleep y jobs para cazar el PID antes del kill. Los permisos de renice: bajar de nice 15 a 5 exige root, y sin sudo la terminal lo rechaza. Y la indentación en nano: al descomentar el Lock o cambiar una variable, un espacio de más produce IndentationError.

«Ver en vivo cómo interactúan las señales con el sistema: la diferencia real entre mandar un kill -15, donde el proceso se entera y puede cerrar sus cosas con calma, y clavarle un kill -9, que lo fulmina de inmediato desde el kernel.»

Juan Esteban Bustos Chilatra

«Amplié mis conocimientos del sistema operativo Debian, profundizando en el monitoreo del procesador y los recursos con top y htop, en la finalización controlada de procesos con kill y en la condición de carrera, que ocurre solo por falta de orden de ejecución.»

Juan Sebastián Tafurth Cortés
00

Parte 0 — Preparación

Dos máquinas,
una red privada.

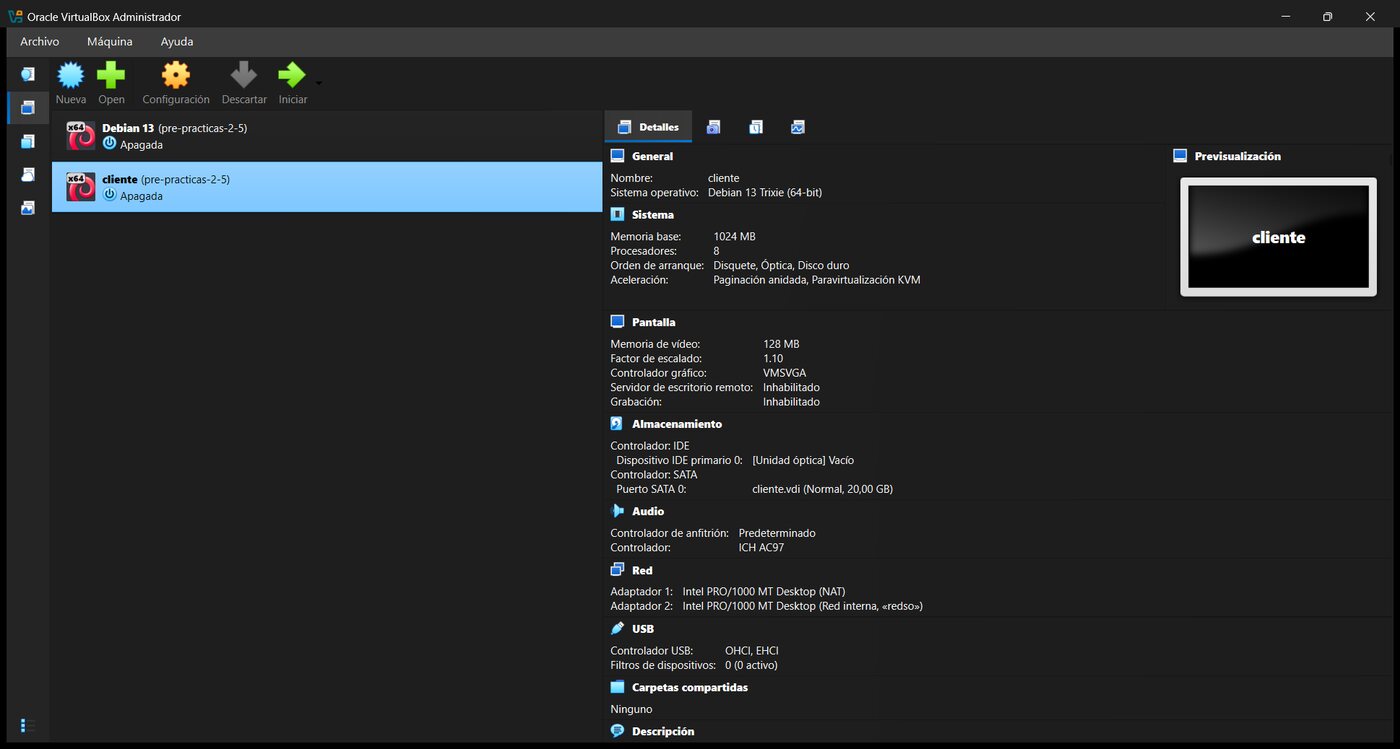
El servidor se clona para crear el cliente y se conectan por una red interna llamada redso. El NAT sigue dando internet; la red interna solo une a las dos VM. Antes de tocar nada, se toma una fotografía del sistema: la línea base.

servidorVM 1
IP interna192.168.100.10
Interfazenp0s8
NAT10.0.2.15
RolServidor / respaldos
darknesspain · Debian 13
clienteVM 2 · clon
IP interna192.168.100.11
Interfazenp0s8
Memoria1024 MB
RolAdministración / copia
lector · clon completo

Lo que se hizo

  • Clon completo del servidor con MAC reinicializada.
  • Adaptador 2 en Red interna «redso» en ambas máquinas.
  • hostnamectl set-hostname y entradas en /etc/hosts.
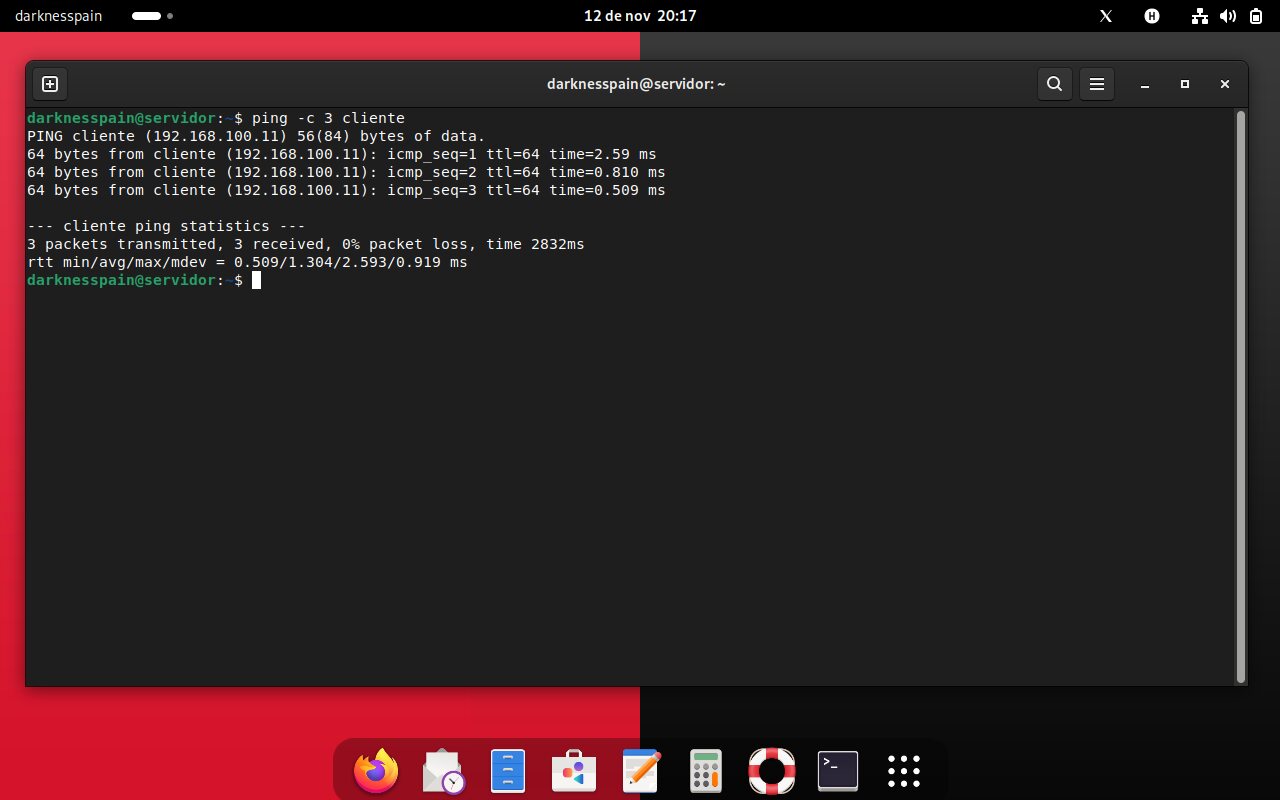
  • Direcciones fijas con nmcli y prueba con ping -c 3 cliente.
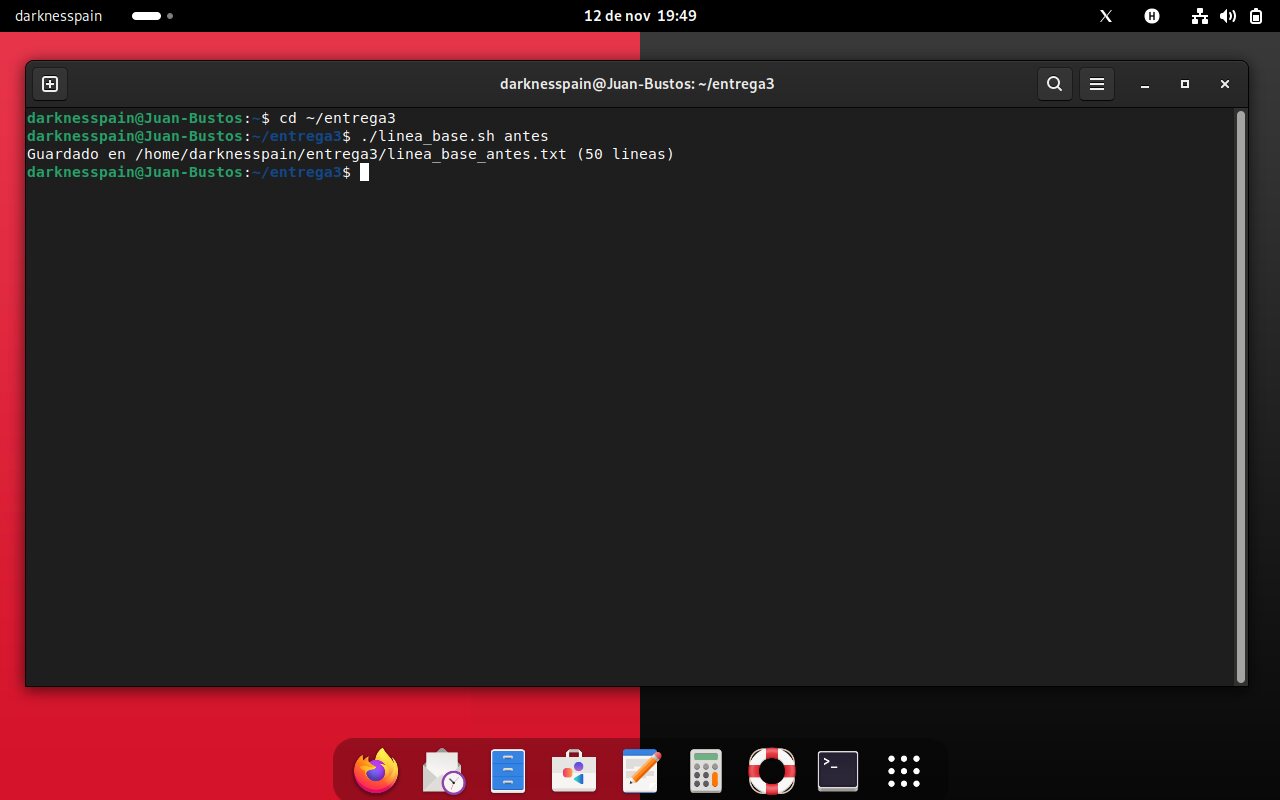
  • Línea base del servidor guardada en linea_base_antes.txt.

La línea base, en corto

Swap2 087 MBsda5 + zram0
Discossolo sda1sin /datos
Interfacesenp0s3solo NAT
SSH22/tcpcon contraseña
Usuariosroot, darknesspainsin lector

Estos valores se comparan al final, en la Parte G.

VirtualBox con las máquinas servidor y cliente
Fig. 0.1 Dos VM clonadas
ping al cliente desde el servidor
Fig. 0.2 ping entre nodos
Línea base antes de la entrega
Fig. 0.3 Línea base
A

Parte A — Gestión de la memoria

La RAM es una promesa.
El swap, la letra pequeña.

Se midió la memoria real, se creó un área de intercambio propia, se provocó su uso con un programa que reserva memoria y se compararon FIFO, LRU y Óptimo. Todo con los números de la máquina, no con los del libro.

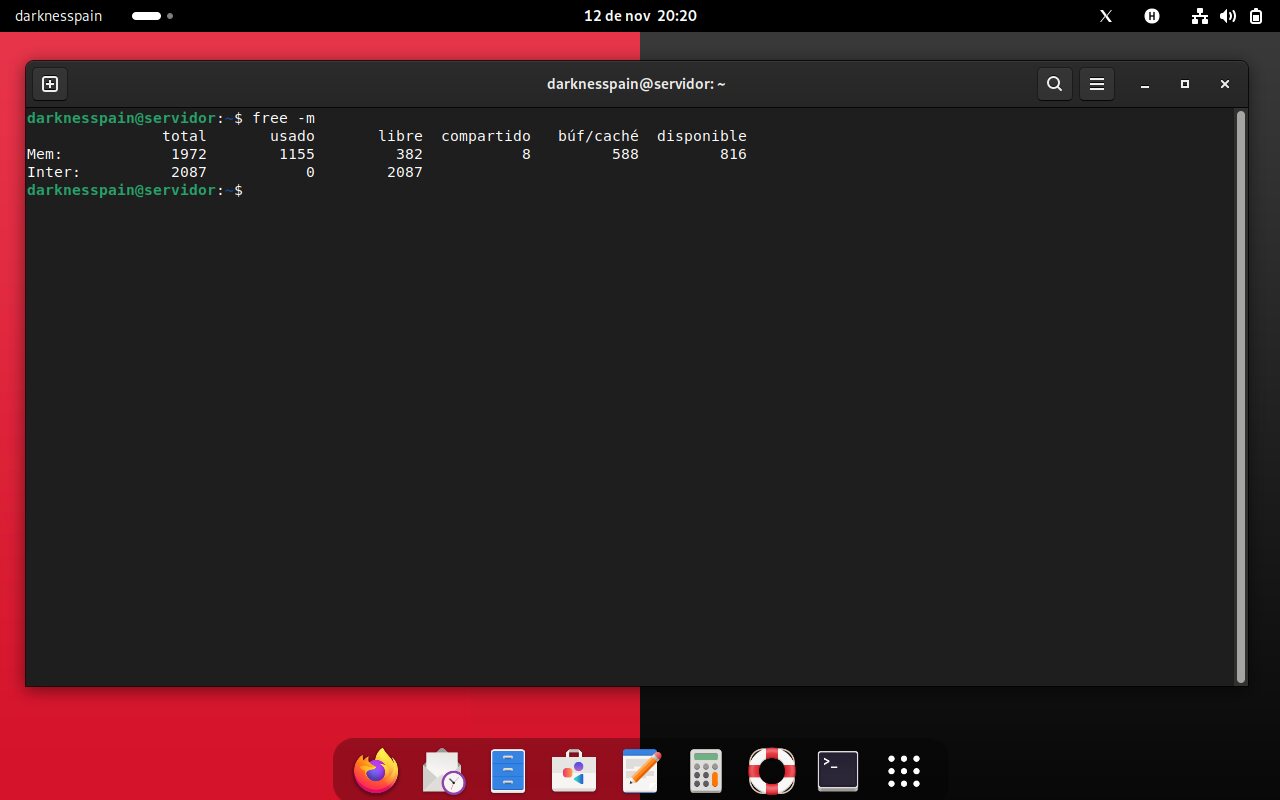
RAM total1 972MBMemTotal 2 019 380 kB
Disponible (D)825MBMemAvailable 845 092 kB
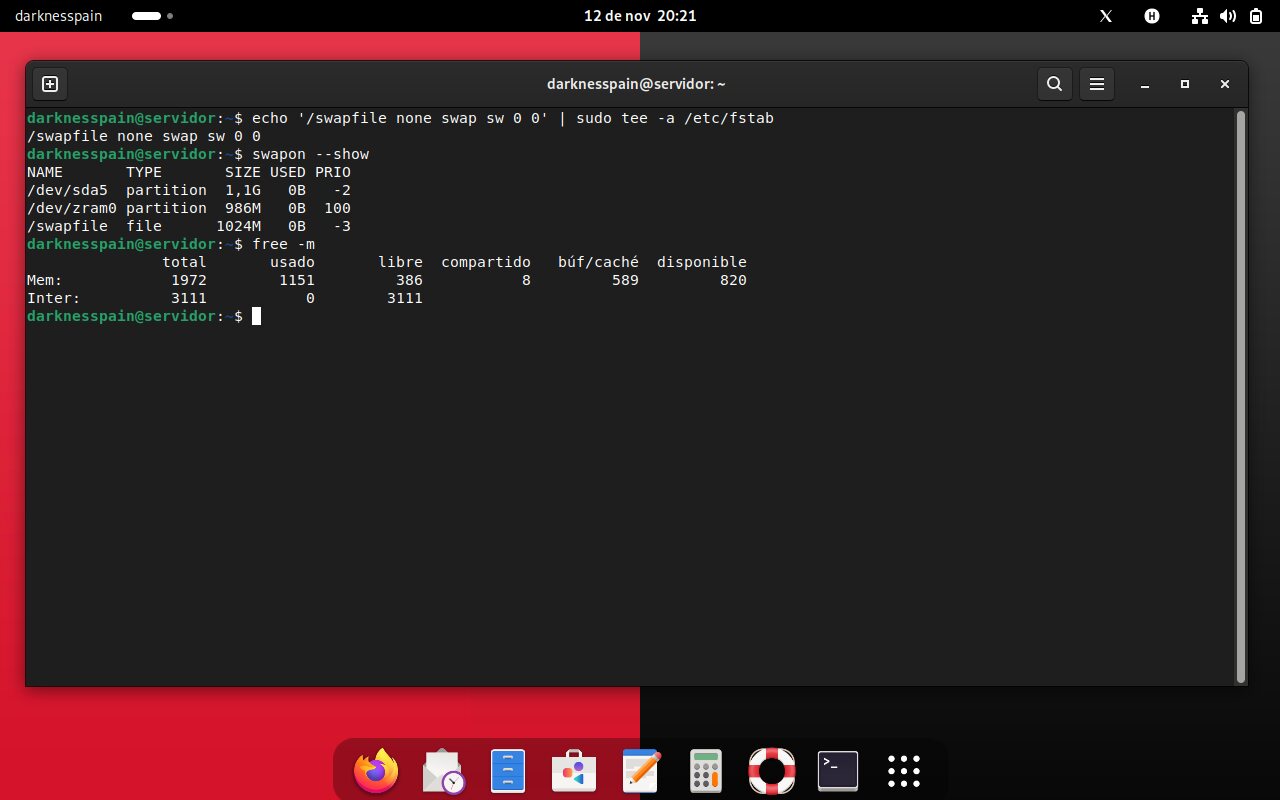
Swap tras A.23 111MB3 áreas · PRIO 100, −2, −3
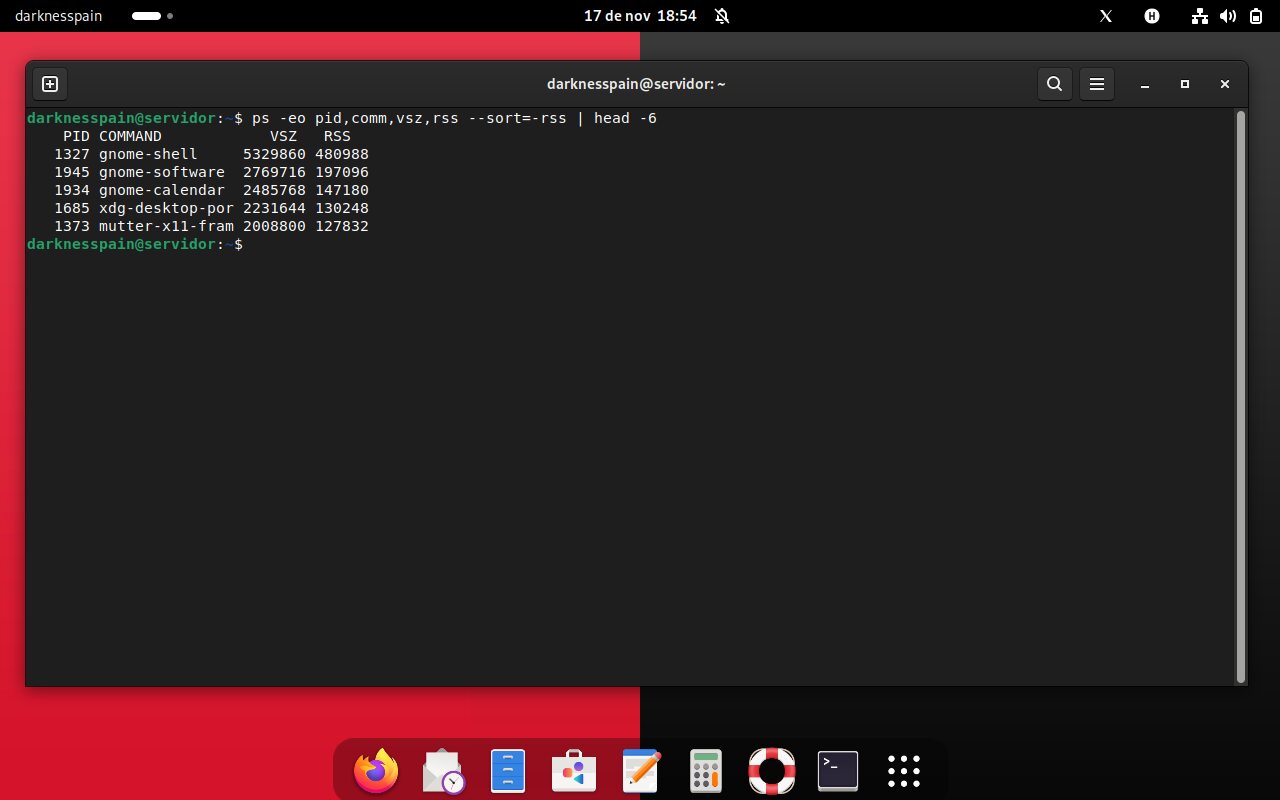
Proceso con más RSSgnome-shellVSZ 5 329 056 kB · RSS 479 508 kB

A.1 · Lo que ve el sistema

VSZ de 5,3 GB en una máquina de 1,9 GB

El espacio de direcciones es lógico: el kernel promete rangos y asigna marcos físicos solo cuando la página se toca —paginación por demanda. Por eso el escritorio «cree» tener más memoria que la máquina entera. La traducción la hacen la MMU, la tabla de páginas y el TLB.

$ free -m · grep MemTotal /proc/meminfo · ps -eo pid,comm,vsz,rss --sort=-rss | head -6
Salida de ps con VSZ y RSS
Fig. A.1 VSZ frente a RSS
A.2

Un swap propio

fallocate -l 1G /swapfile, chmod 600, mkswap, swapon y una línea en /etc/fstab para que sobreviva al reinicio.

PRIO

¿Quién se usa primero?

El número mayor gana: zram0 (100) se usa antes que la partición sda5 (−2) y que el archivo /swapfile (−3). Es la prioridad del área de intercambio.

swappiness

10, y luego 60

Se fijó en 10 de forma permanente en /etc/sysctl.d/99-swappiness.conf y se subió a 60 solo para el tercer experimento.

Visualización 3D · interactiva

La jerarquía de memoria, en perspectiva

Arrastra para girar. Cada nivel es más grande y más lento que el anterior. Modelo 3D dibujado en canvas para esta página, no es una captura.

CPU / caché RAM Swap Disco
arrastra
Caché / CPUnanosegundos
RAM 1 972 MB~100 ns · se pierde al apagar
Swap 3 111 MBzram comprimida + disco
/datos 989 MBmilisegundos · persiste

A.3 · Cuando la RAM no alcanza

El experimento que hizo lento al servidor

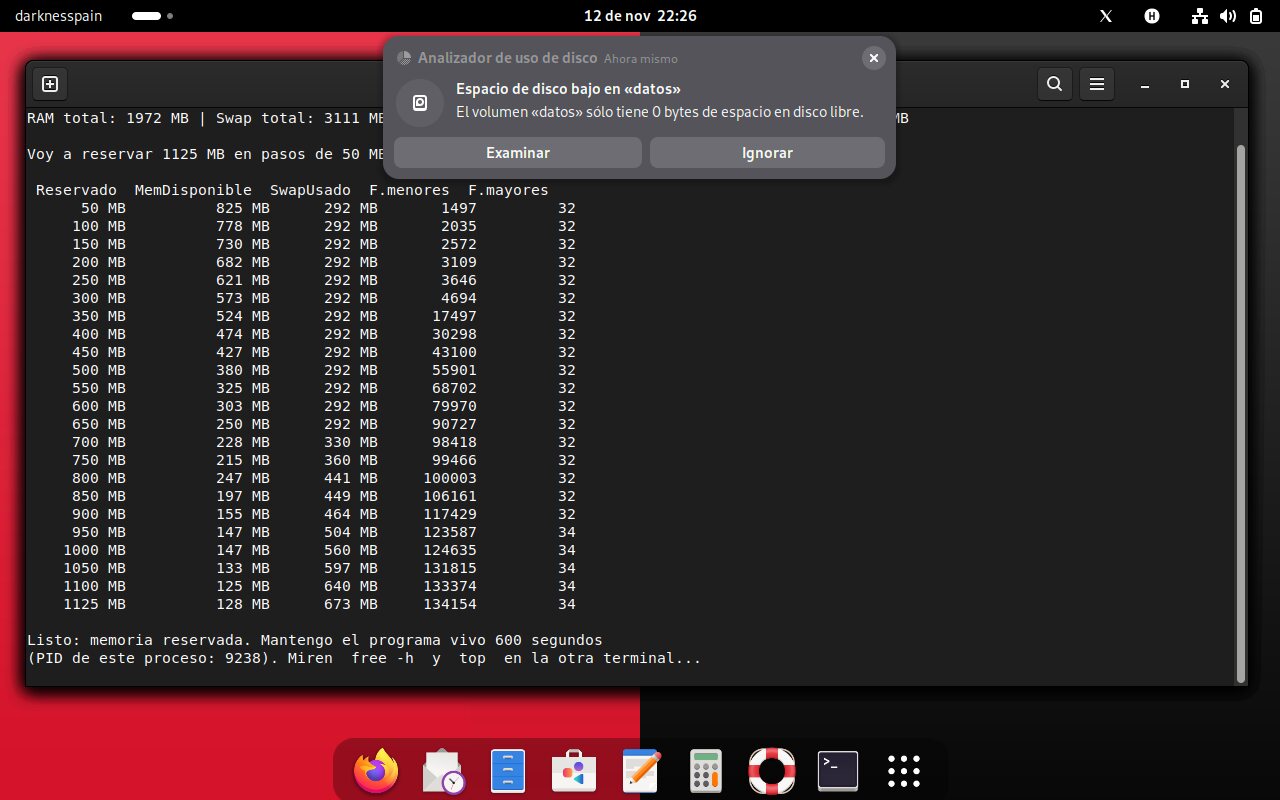
Con D = 825 MB, se reservaron 412 MB (D/2) y luego 1125 MB (D+300), primero con swappiness 10 y después con 60. El programa escribe una página cada 4 KB para forzar la asignación real y reporta RAM, swap y fallos.

Exp. 1 · 412 MB0 MBswap · 0 fallos mayores · sin si/so
Exp. 2 · 1125 MB446 MBswap · aparecen fallos mayores · si/so > 0
Exp. 3 · swappiness 60385 MBswap · 26 fallos mayores · predicción fallida

La predicción del Exp. 3 decía «más swap que el 2» y ocurrió lo contrario. Se dejó escrito: con la memoria tan justa, el kernel recurre al swap en ambos casos y la diferencia depende de la caché recuperada y de la compresión de zram, no solo de swappiness.

Swap usado al final de cada experimento MB

Fallos mayores: 0 → aumentan → 26D = 825 MB

Simulador interactivo · A.4

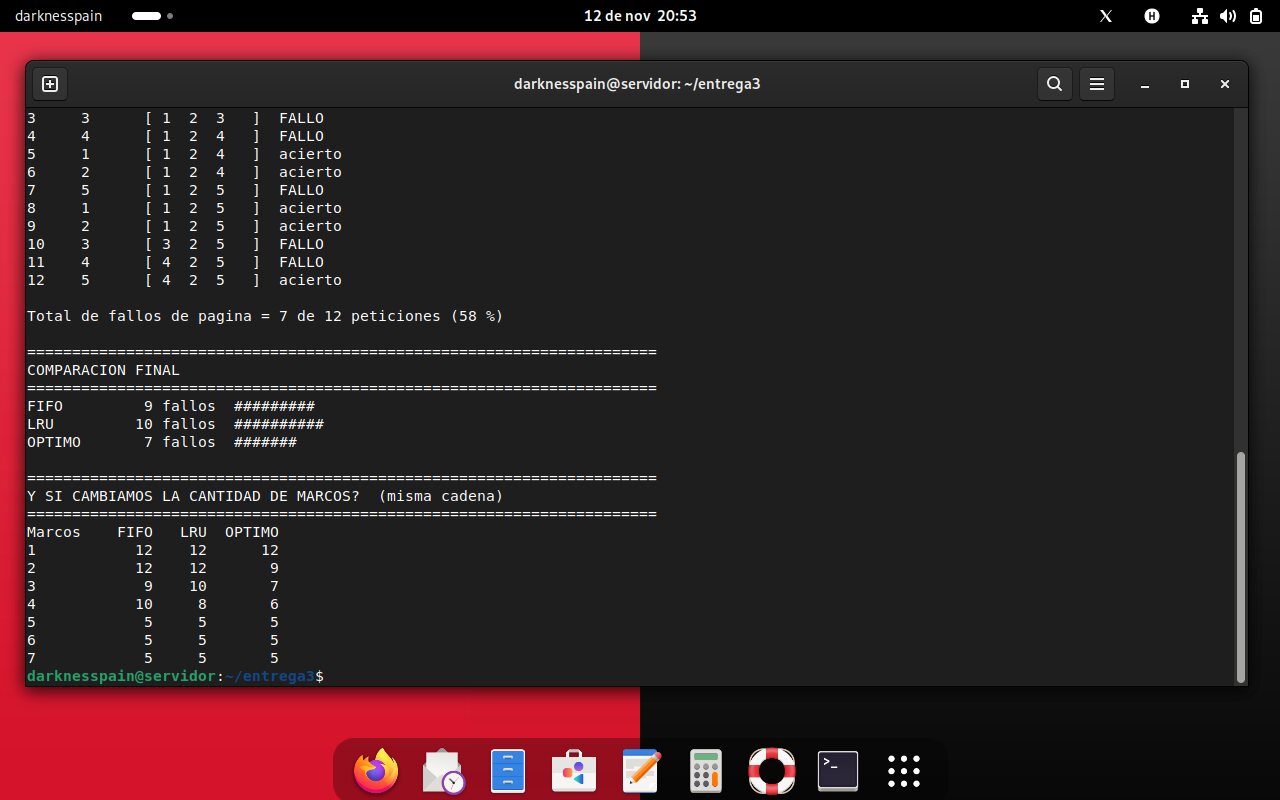
FIFO, LRU y Óptimo, paso a paso

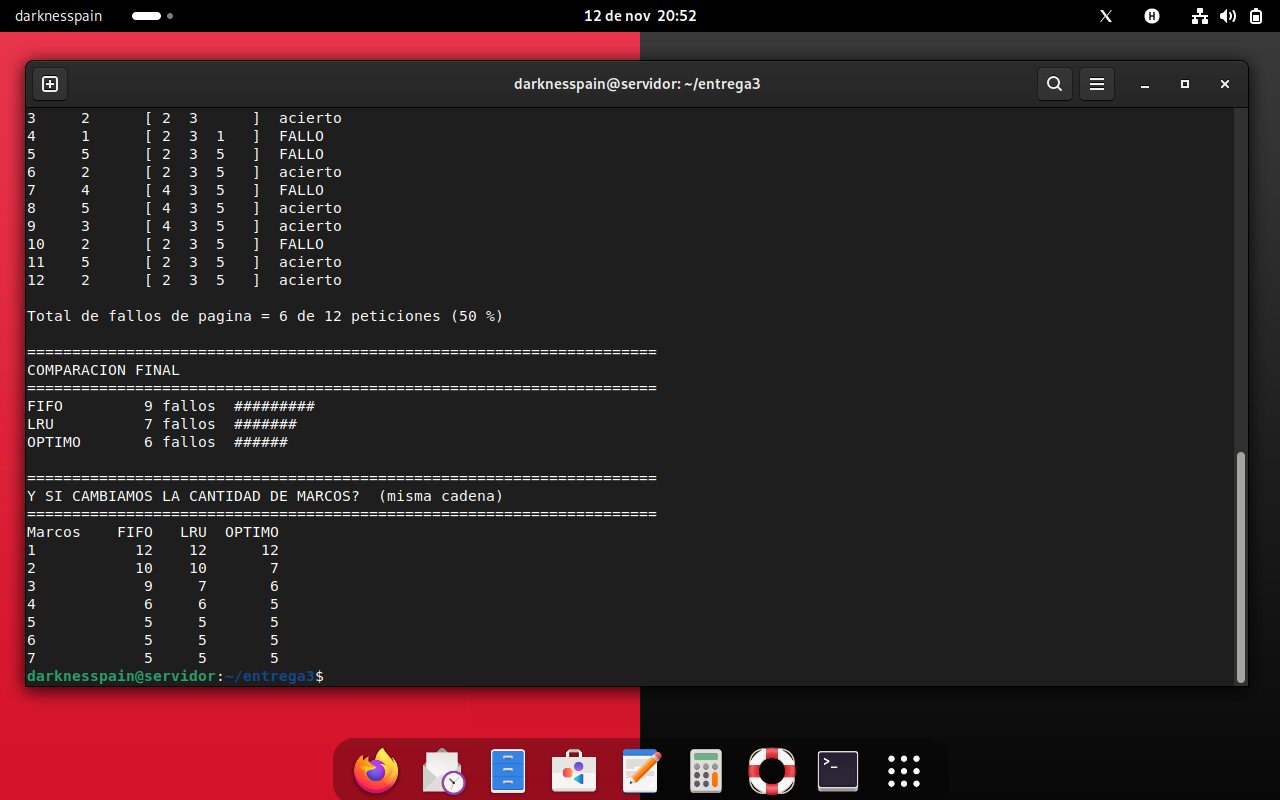
Cadena de Belady 1 2 3 4 1 2 5 1 2 3 4 5. Cambia de algoritmo y de marcos: mira cómo FIFO empeora al añadir memoria.

Marcos de memoria

Pulsa «Paso» para comenzar.

Fallos0
Aciertos0
Paso0/12
Belady
Algoritmo3 marcos4 marcos¿Mejora al añadir un marco?

La tabla se calcula en vivo con la cadena elegida. En la cadena de Belady, FIFO pasa de 9 a 10 fallos: la anomalía. LRU y el Óptimo son algoritmos de pila y nunca empeoran.

free -m en el servidor
Fig. A.2 free -m
swapfile y fstab
Fig. A.3 swapfile activo
Resultado del experimento 2
Fig. A.4 446 MB de swap
Anomalía de Belady en el simulador
Fig. A.5 Belady
B

Parte B — Sistema de archivos

Un archivo no es un nombre.
Es un inodo.

Se añadió un disco virtual de 1 GB, se particionó, se formateó ext4 y se montó por UUID en /datos. Después se comprobó qué pasa con los enlaces al borrar el nombre original y cómo el setgid y las ACL resuelven lo que chmod no puede.

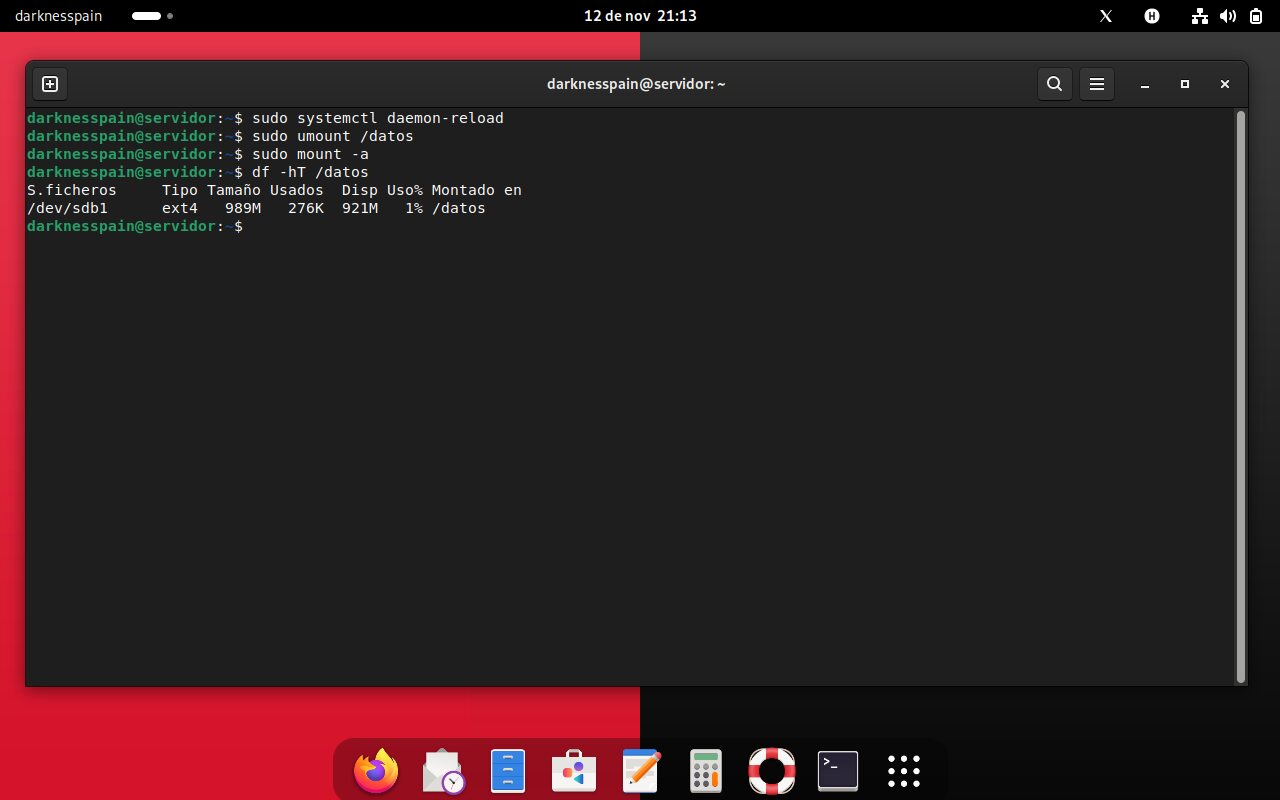
El disco de datos

Discosdb · 1 GB
Particiónsdb1 · ext4
EtiquetaDATOS
Montaje/datos
Tamaño989 MB
UUID1fcfc3ba-1ec1-47b0-8f54-b88c810a32fd
fstabdefaults,nofail 0 2
Inodos65 536

Se usa el UUID y no /dev/sdb1 porque el nombre del dispositivo puede cambiar si mañana se añade otro disco. nofail evita que un disco ausente bloquee el arranque.

df del disco /datos
Fig. B.1 /datos montado por UUID

Demo interactiva · B.3

Borra el nombre y mira quién sobrevive

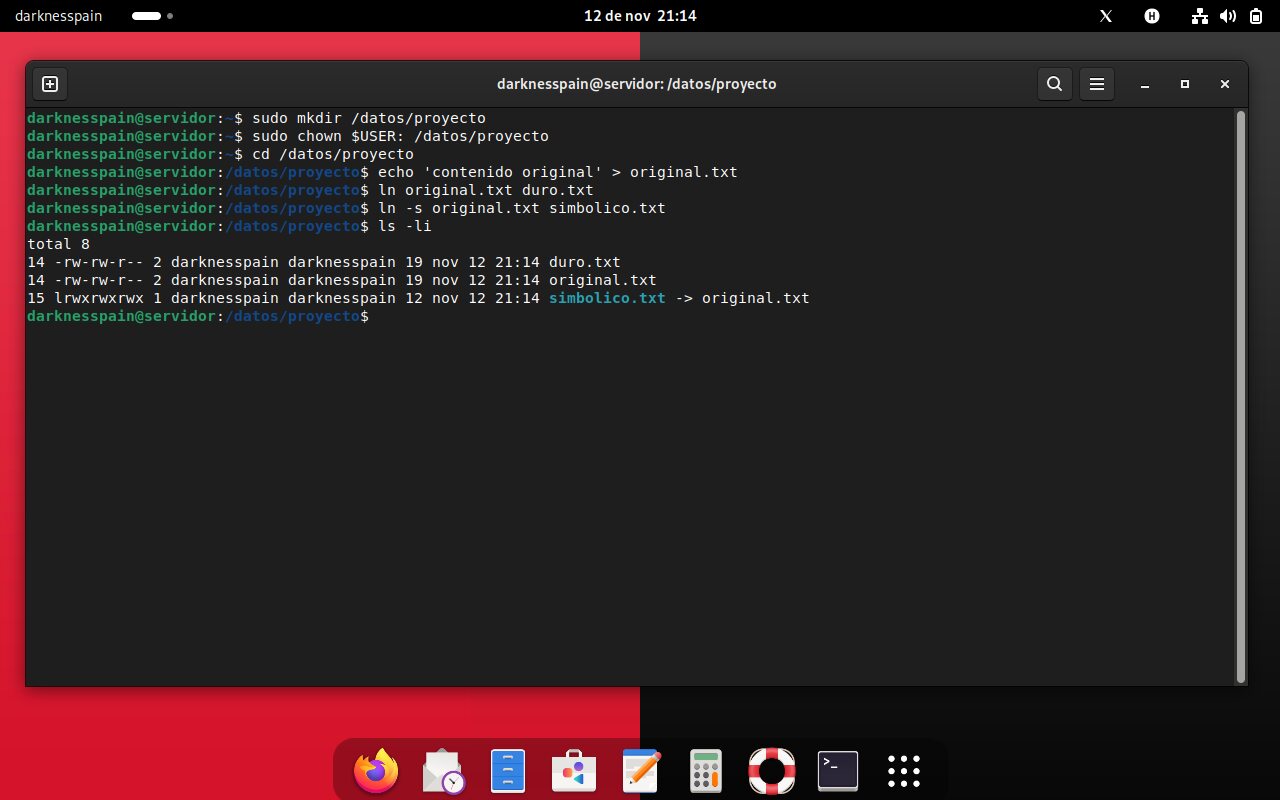
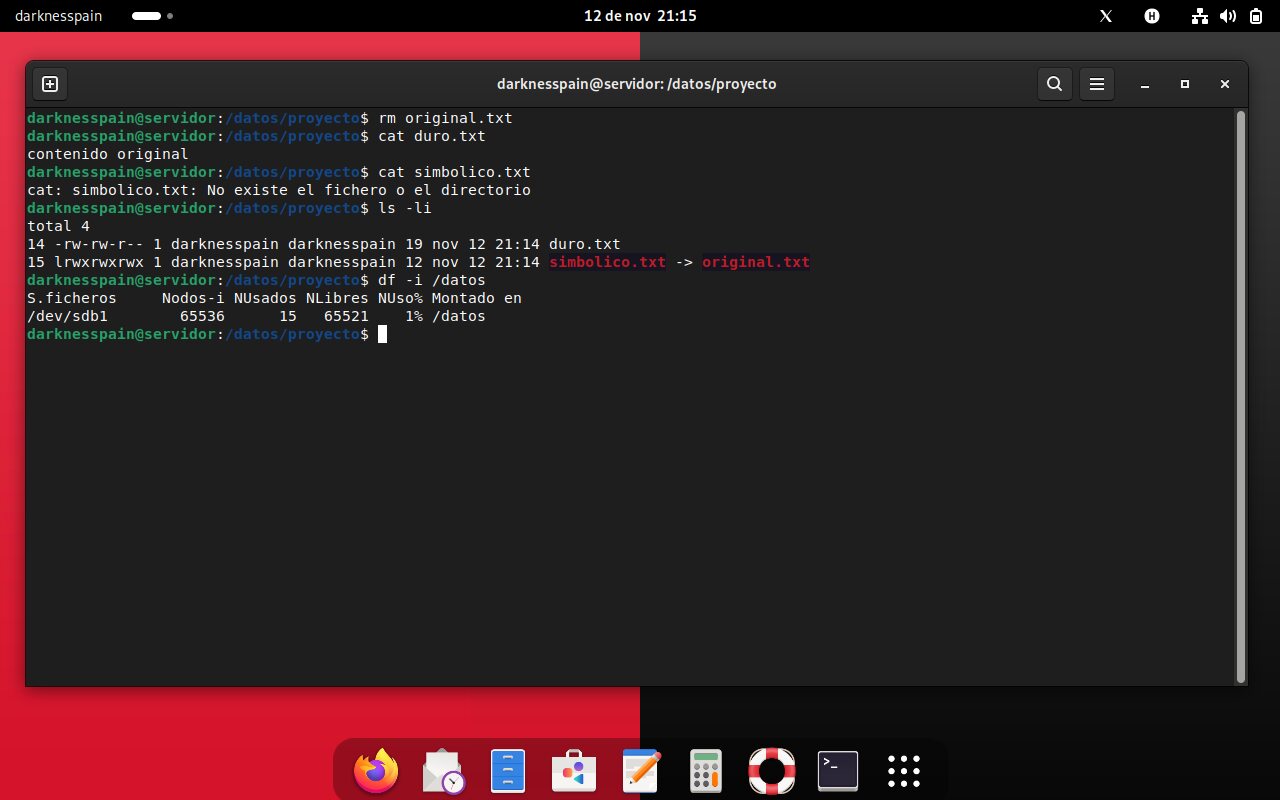
Al crear duro.txt con ln, el contador de enlaces del inodo 14 sube a 2. El enlace simbólico simbolico.txt recibe un inodo nuevo (15) y solo guarda la ruta. Pulsa el botón y comprueba la diferencia.

ls -li3 archivos
14 -rw-r--r-- 2 original.txt leer
14 -rw-r--r-- 2 duro.txt leer
15 lrwxrwxrwx 1 simbolico.txt → original.txt leer
contenido original

Los dos nombres apuntan al mismo inodo; el enlace simbólico es otro inodo.

Protección: grupo, setgid y ACL

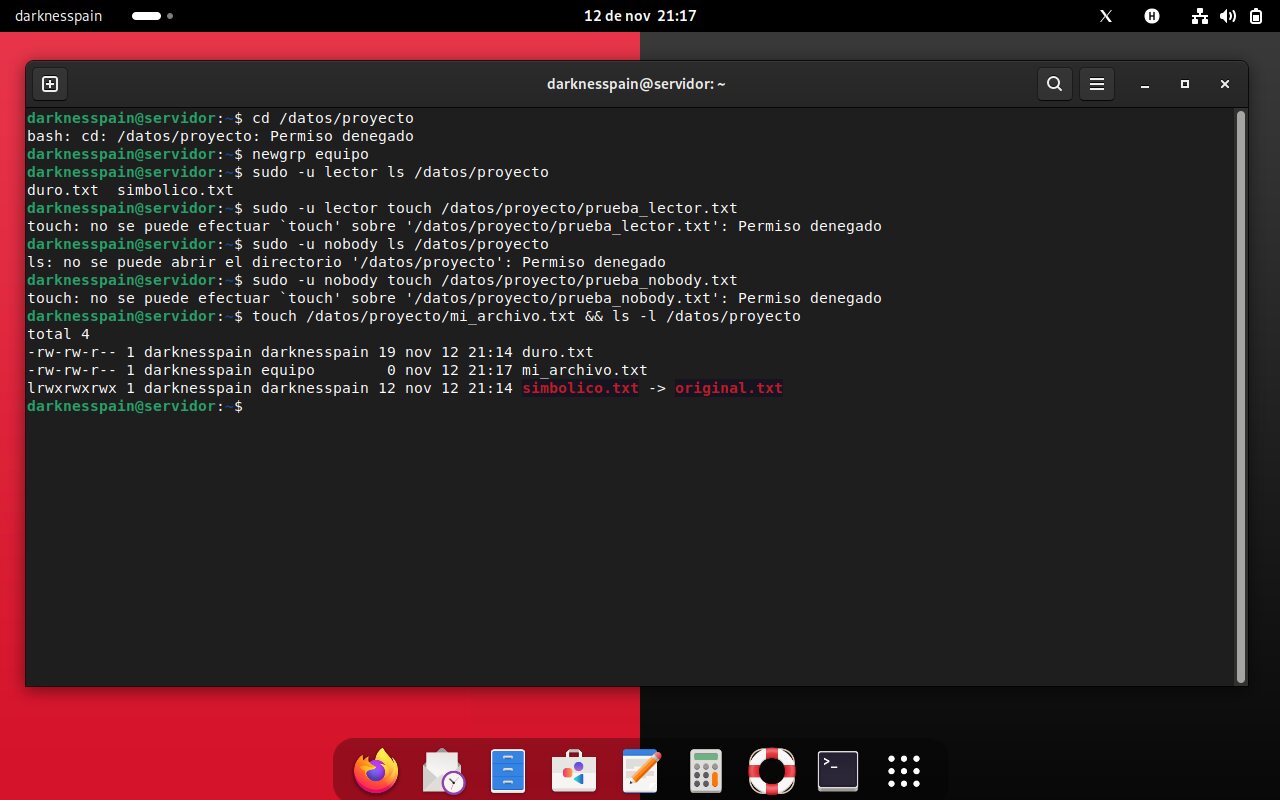
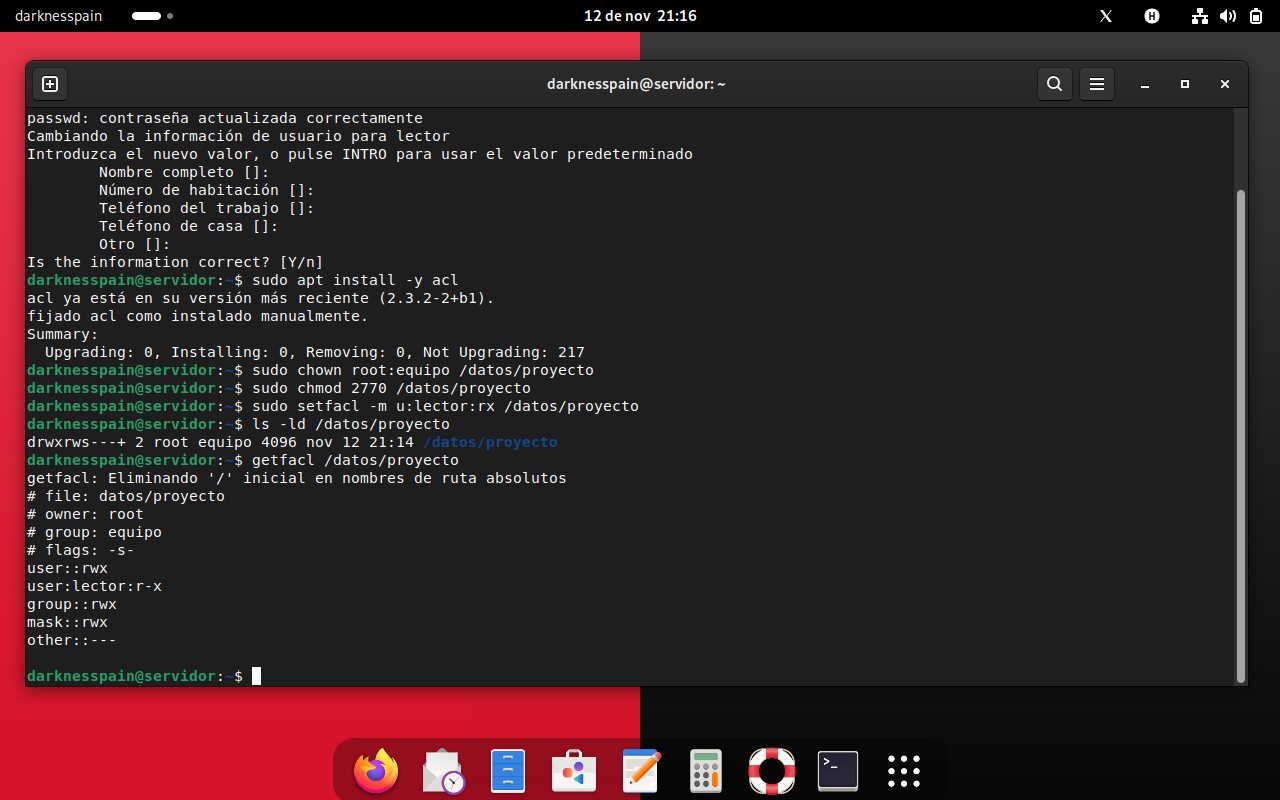
El escenario: el grupo equipo lee y escribe; lector solo lee; cualquier otro no entra.

2770

2 = setgid: los archivos nuevos heredan el grupo equipo.

770 = dueño rwx · grupo rwx · otros nada.

lector:r-x

La ACL nombra a una persona concreta sin abrir la carpeta a «otros».

getfacl es la única forma de verla; ls -l no la muestra.

Acciónlectornobody
Listar (ls)SÍNO
Crear (touch)NONO

Predicción y resultado coincidieron. mi_archivo.txt nació con grupo equipo por el setgid, no con el grupo principal del usuario.

ls -li con inodos y enlaces
Fig. B.2 Mismo inodo, dos nombres
Prueba de borrado del original
Fig. B.3 El enlace roto
getfacl del proyecto
Fig. B.4 setgid + ACL
C

Parte C — Dispositivos

Todo es un archivo,
hasta el disco.

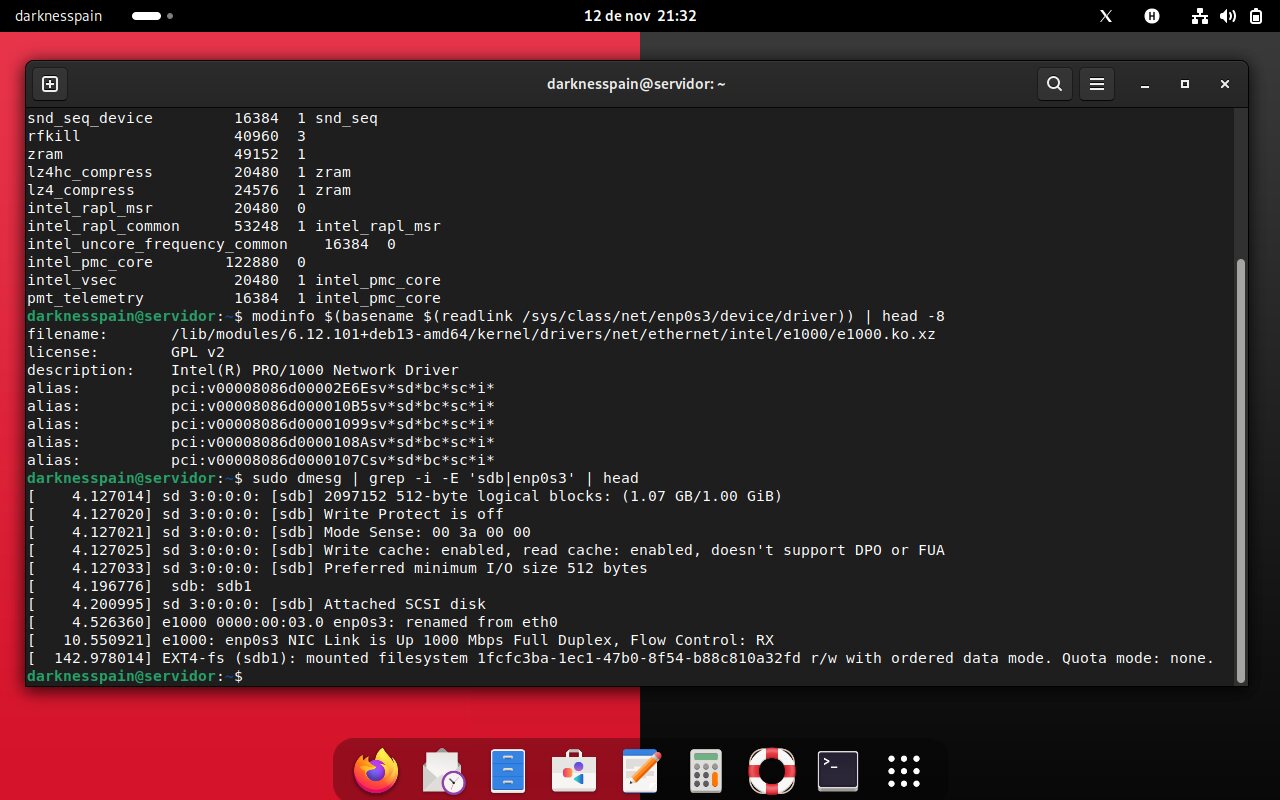
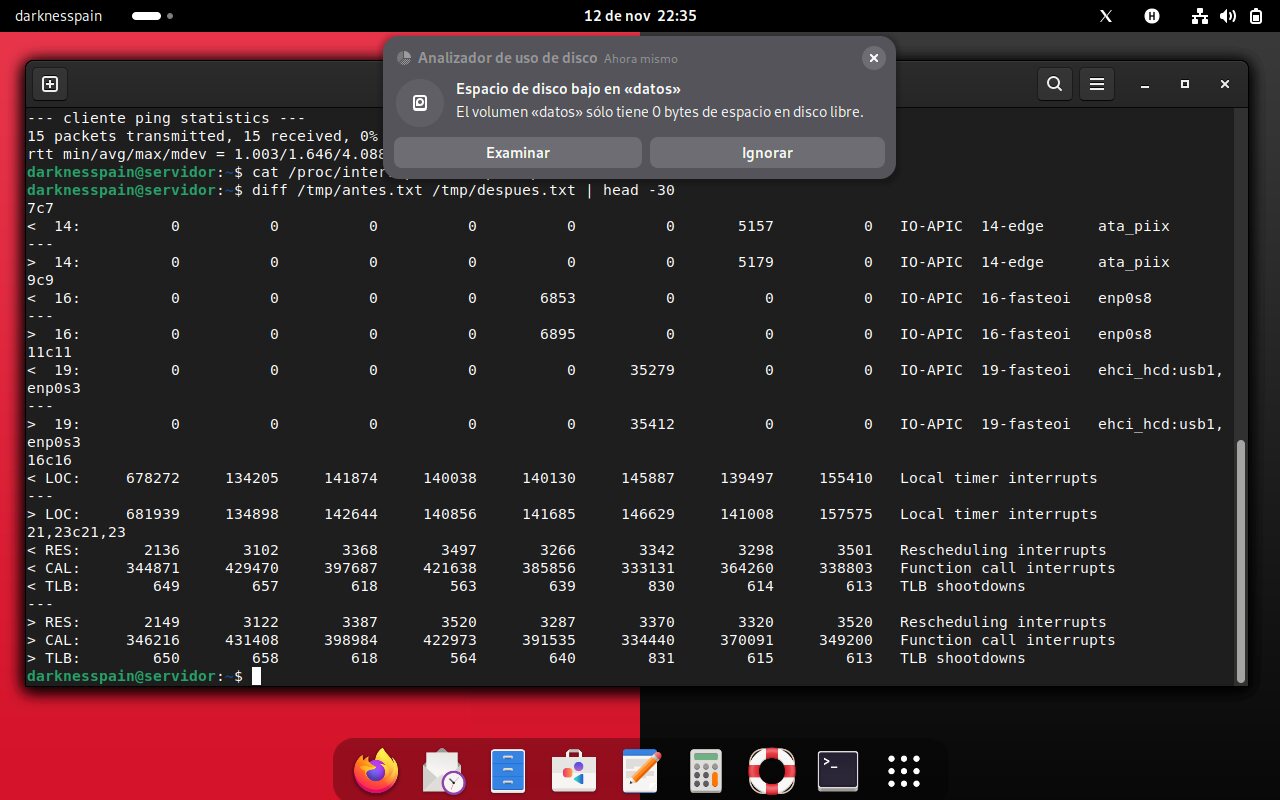
Se distinguieron dispositivos de bloques y de caracteres, se identificó el driver de la tarjeta de red y se comprobó con /proc/interrupts que el hardware avisa a la CPU en lugar de ser interrogado.

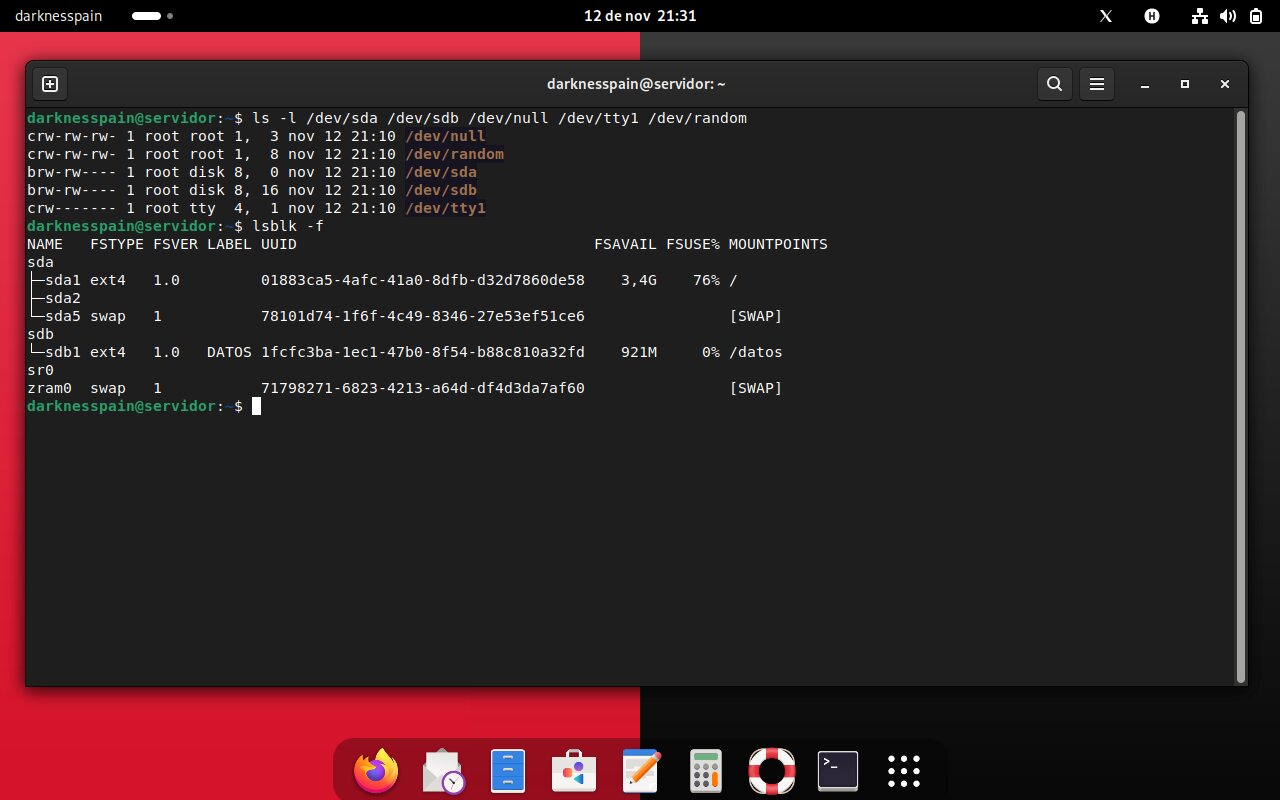
bloque · b

/dev/sda · /dev/sdb

Se leen por bloques y permiten montar un sistema de archivos. El disco de 1 GB apareció como sdb.

carácter · c

/dev/null · /dev/tty1 · /dev/random

Se leen byte a byte, sin búfer ni sistema de archivos. Cada uno tiene una función distinta.

driver

e1000

La tarjeta es una Intel 82540EM emulada por VirtualBox, en 00:03.0 (NAT) y 00:08.0 (red interna). El módulo e1000 aparece en lsmod y traduce entre el hardware y la pila de red.

C.3 · Encuesta frente a interrupción

El hardware toca el timbre

Se guardó /proc/interrupts antes y después de tres actividades. El resultado más grande lo produjo dd, porque mueve cientos de megabytes; el ping genera eventos de red y el teclado, dos por tecla (pulsar y soltar).

ping -c 15 clientetarjeta de redenp0s8 / enp0s3
dd if=/dev/sda … count=300controlador de discoahci / sda
escribir en el tecladocontrolador PS/2i8042

La encuesta (polling) se prefiere cuando hay muchísimos eventos por segundo y el coste de atender una interrupción por cada uno sería mayor que preguntar; los kernels modernos combinan ambas con NAPI.

Dispositivos de bloque y caracteres
Fig. C.1 b frente a c
Driver e1000 y dmesg
Fig. C.2 driver e1000
Interrupciones tras el ping
Fig. C.3 IRQ del ping
D

Parte D — Seguridad y administración

Una sola puerta abierta.
Y con llave.

El firewall se configuró permitiendo SSH antes de activarlo; SSH dejó de aceptar root y, más tarde, también contraseñas. Los registros se leyeron y los respaldos quedaron programados cada cinco minutos, con copia fuera del servidor.

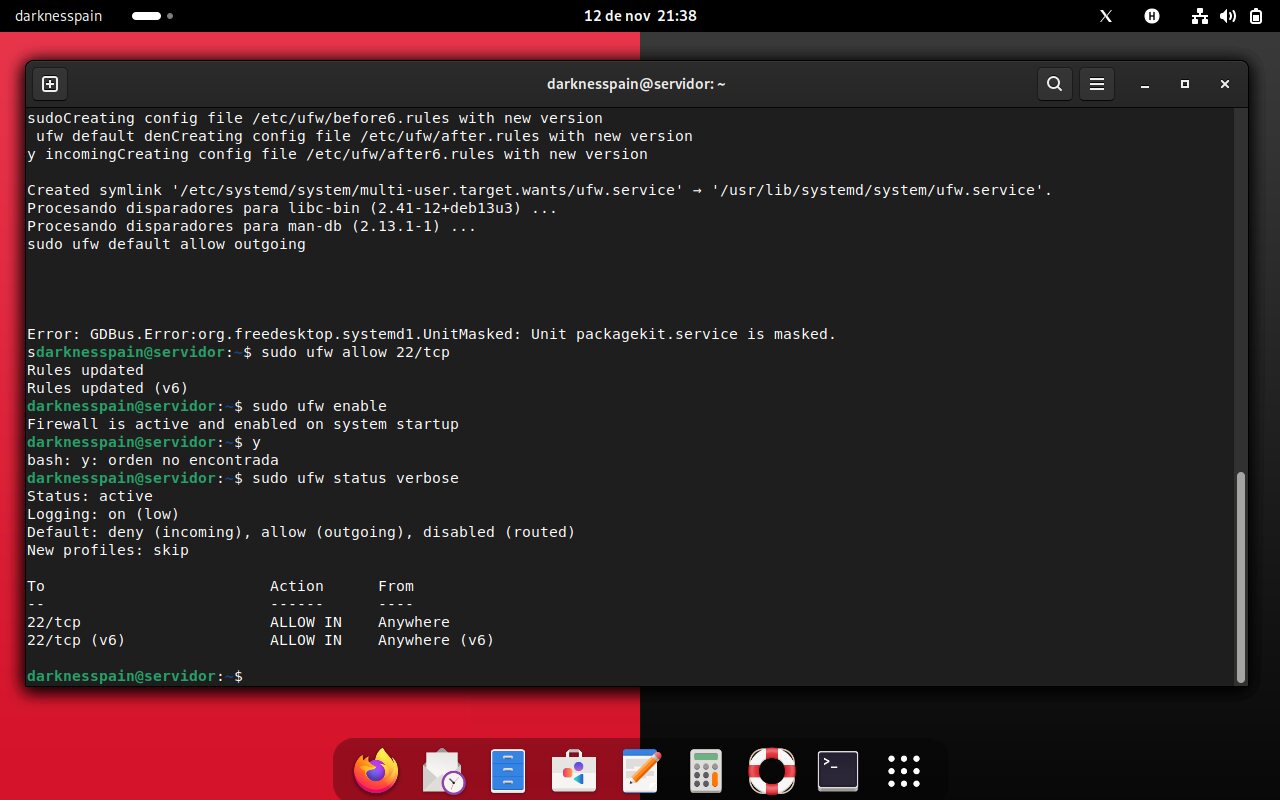
D.1 · ufw

El orden importa

  1. default deny incoming
  2. default allow outgoing
  3. allow 22/tcp — primero
  4. ufw enable — después

Activar ufw sin permitir el 22 deja al cliente fuera. Es el error que se provocó a propósito en el Incidente 4.

22SSHPERMITIDO
ufw · deny incoming
80443330654328080

Solo el puerto 22 escucha. Todo lo demás se rechaza por política, sin reglas extra.

D.2

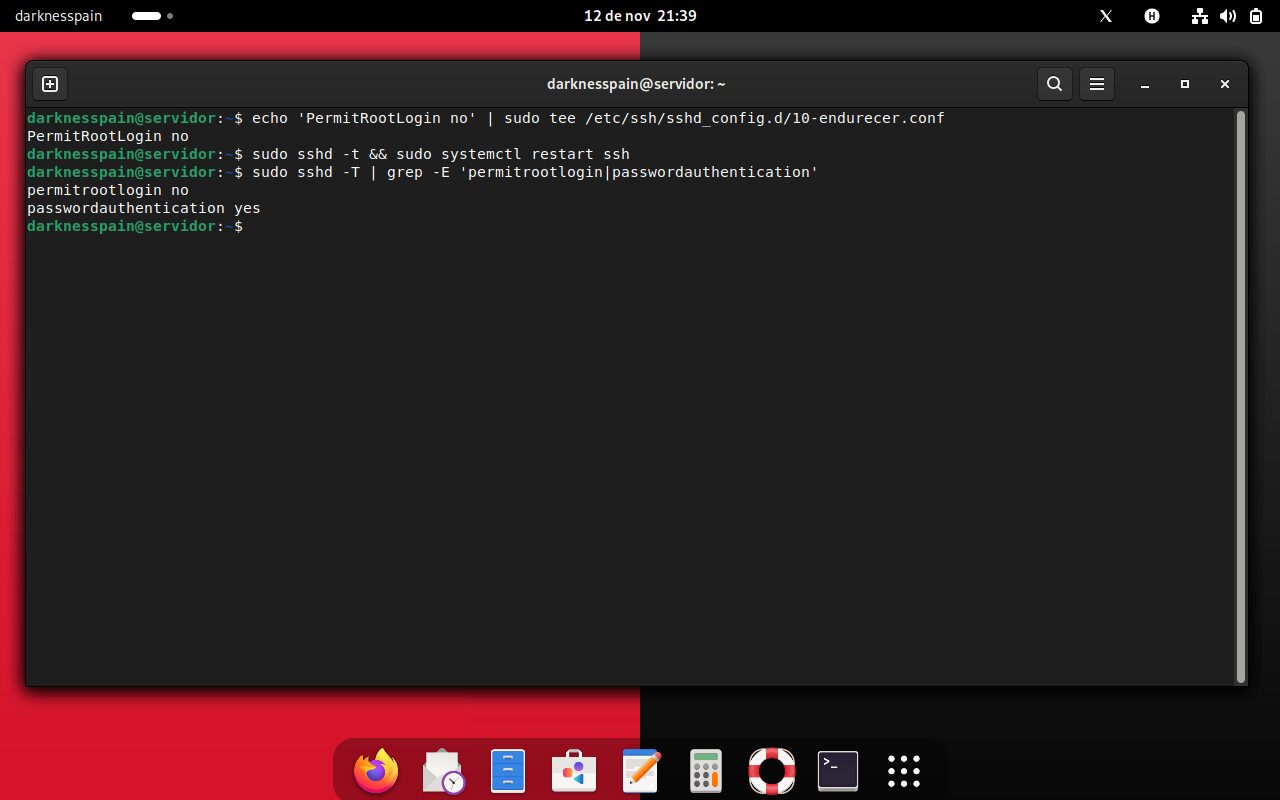
sshd endurecido

PermitRootLogin no y, cuando las llaves funcionaron en ambos sentidos, PasswordAuthentication no. Se valida con sshd -t antes de reiniciar.

D.3

Leer los registros

journalctl -p err -b para errores del arranque, journalctl -u ssh para el servicio y last -n 5 para los últimos ingresos.

D.4

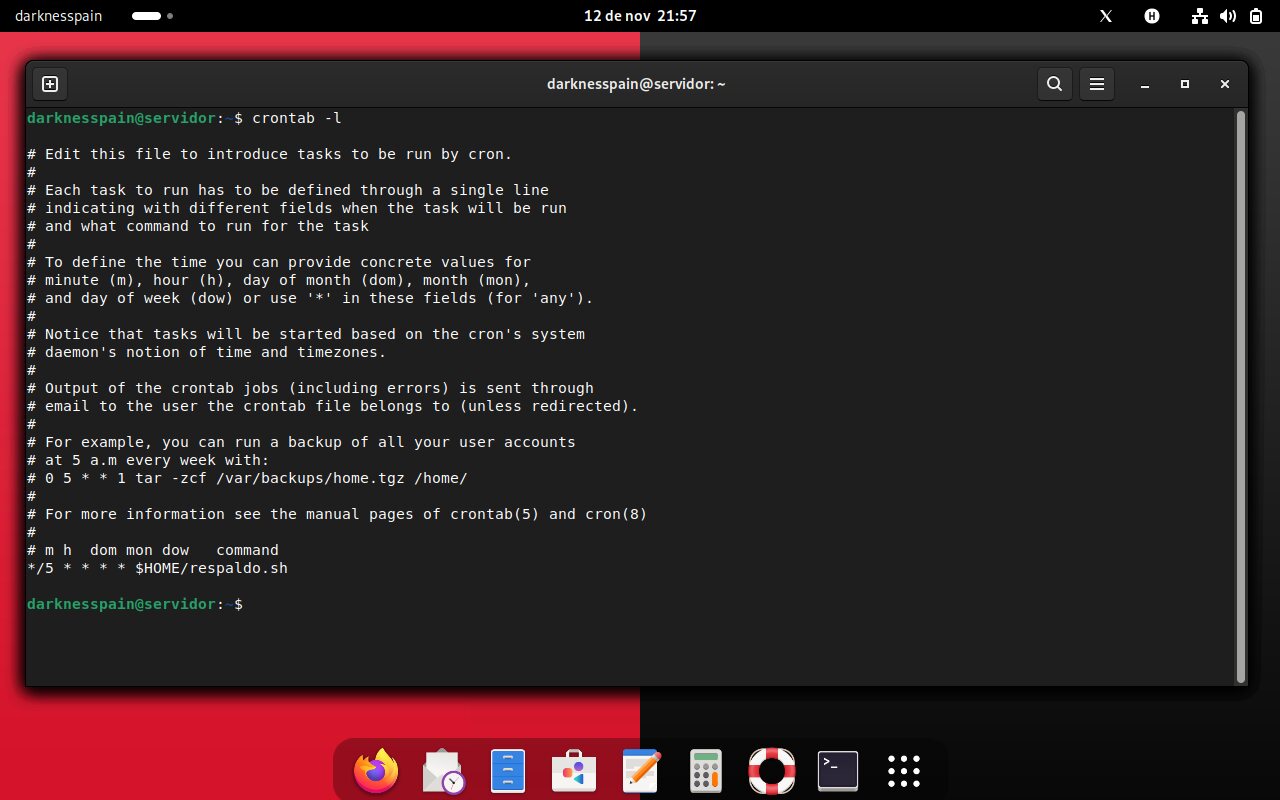
Respaldo cada 5 minutos

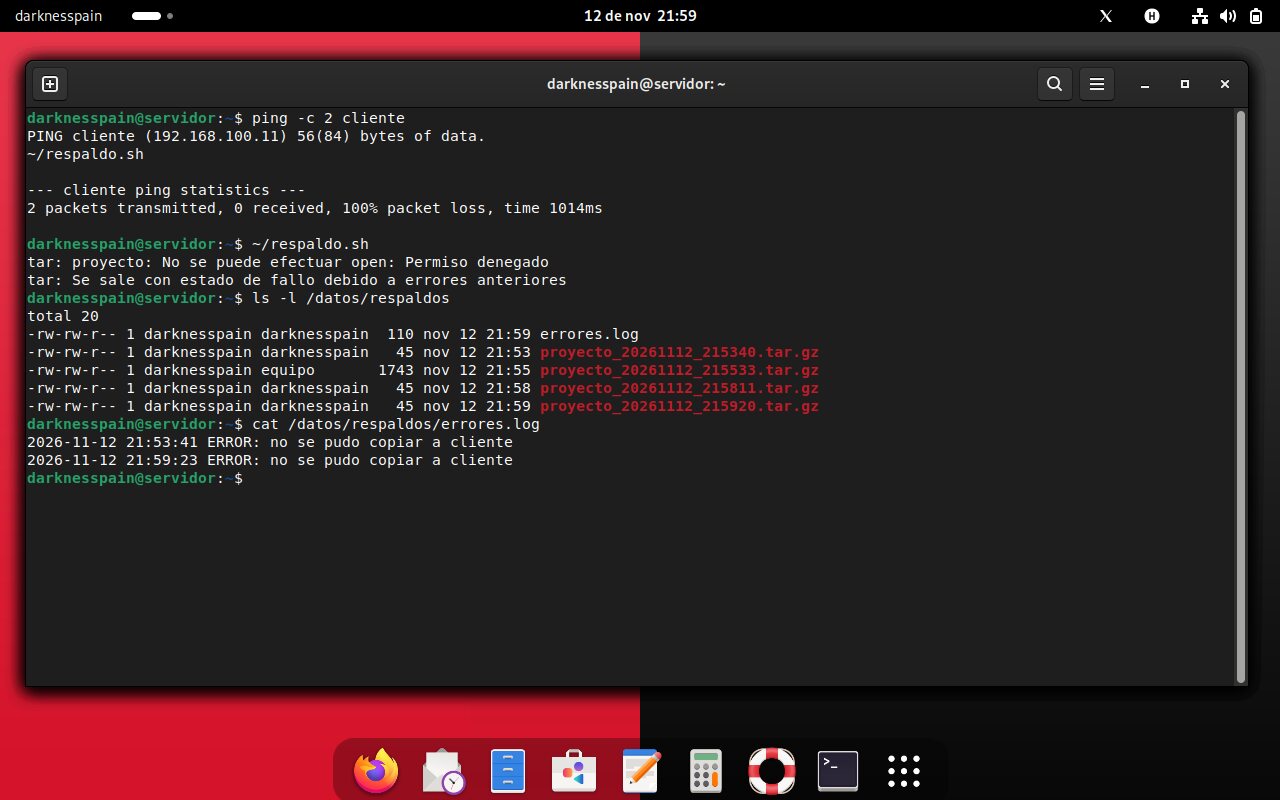
tar czf de /datos/proyecto, rsync al cliente y rotación: solo se conservan los 5 últimos. El error remoto se anota en errores.log.

cron · */5 * * * *rotación: 5
00:00respaldo 1
00:05respaldo 2
00:10respaldo 3
00:15respaldo 4
00:20respaldo 5
+5 minborra el más viejo

Cada ejecución crea un .tar.gz nuevo en /datos/respaldos, lo copia a cliente:~/respaldos_servidor y elimina el más antiguo. Nunca hay más de cinco.

Estado de ufw
Fig. D.1 ufw activo
SSH endurecido
Fig. D.2 sshd -T
crontab del usuario
Fig. D.3 crontab -l
E

Parte E — Sistema distribuido de dos máquinas

Dos kernels.
Un solo servicio.

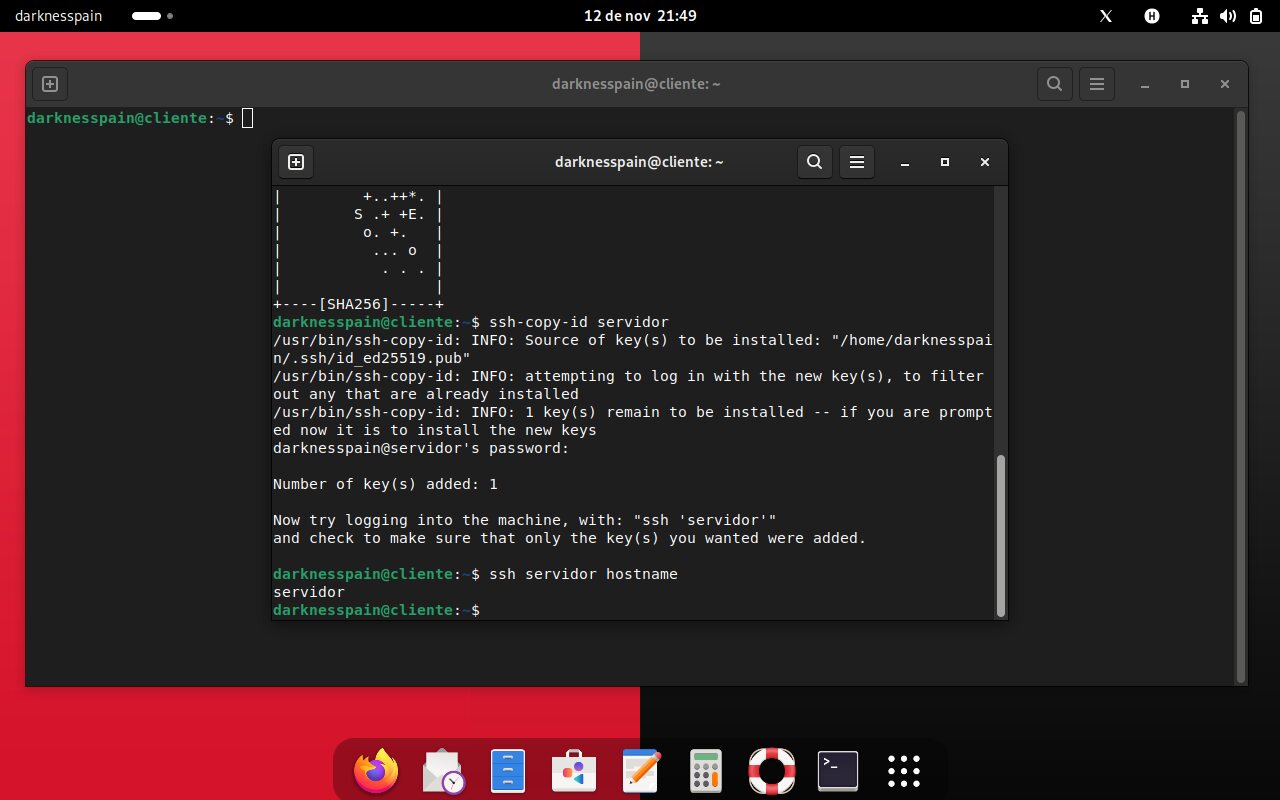
Se generaron llaves ed25519 en ambos sentidos, se desactivó la contraseña y el cliente pasó a administrar el servidor a distancia. Después se apagó el cliente a propósito para ver qué sobrevive.

Visualización 3D · interactiva

Qué pasa cuando cae un nodo

Arrastra para girar. Pulsa «apagar cliente» y observa: el servidor sigue, la copia remota falla y el rastro queda en un log.

servidorclienteenlace SSH
arrastra
cliente en línea · rsync OK
Servidor192.168.100.10 · sigue operando
Respaldo localse crea igual: tar solo depende de /datos
Copia remotarsync falla en segundos (BatchMode, timeout 5)
Rastro/datos/respaldos/errores.log

Lo que se demostró

  • SSH sin contraseña en los dos sentidos con llaves ed25519.
  • Administración remota: hostname, uptime, free, df, ufw status y scp del inventario.
  • Con el cliente apagado, el respaldo local se crea y el remoto falla; el error queda registrado.
  • Al reencenderlo, rsync recupera la copia pendiente.

Lo que faltaría en un sistema real

Sin réplicasi cae el servidor, el servicio se detiene.
Sin heartbeatnadie detecta automáticamente que un nodo desapareció.
Sin quórumno hay consenso ni elección de líder.
Sin copia externaun incendio se lleva las dos máquinas.

Hay tolerancia a fallos mínima e independencia de fallos; falta todo lo que convierte dos máquinas en un sistema distribuido de verdad.

SSH sin contraseña
Fig. E.1 llave en ambos sentidos
Respaldo con el cliente apagado
Fig. E.2 fallo parcial
F

Parte F — Incidentes

Cuatro fallas.
Cero reinicios a ciegas.

Un integrante provoca la avería y el otro diagnostica. La regla: encontrar la causa, no reiniciar y ya. Cada ficha tiene síntoma, comandos, evidencia, causa raíz, solución y prevención.

Síntoma

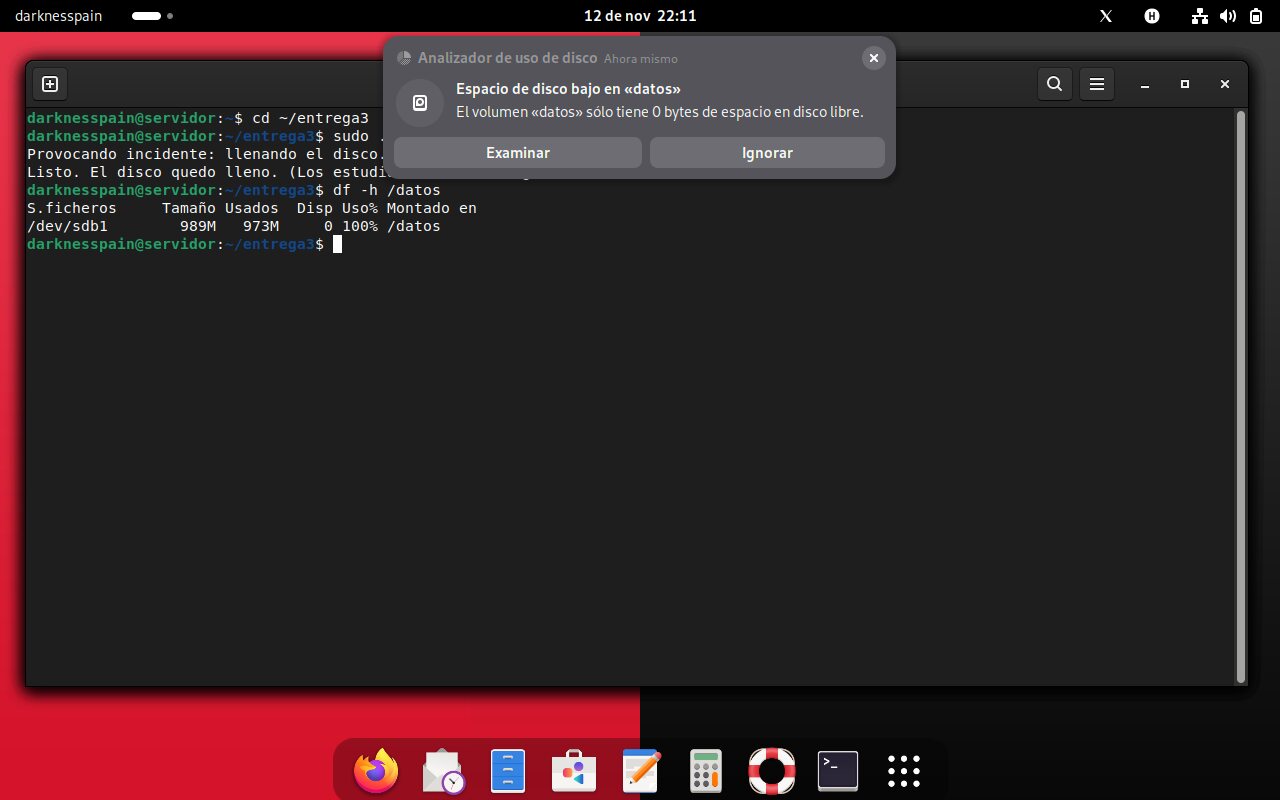
No se puede crear ningún archivo en /datos/proyecto.

Diagnóstico

df -h /datos marca 100 %. du -sh /datos/* señala la carpeta que pesa.

Evidencia

servicio.log de 1 019 318 272 bytes (~1 GB) ocupando el disco entero.

Causa raíz

Un registro que crecía sin rotación.

Solución

Borrar el archivo y liberar el espacio; verificar con df -h.

Prevención

logrotate, límites de tamaño y alerta al 80 % de uso.

Síntoma

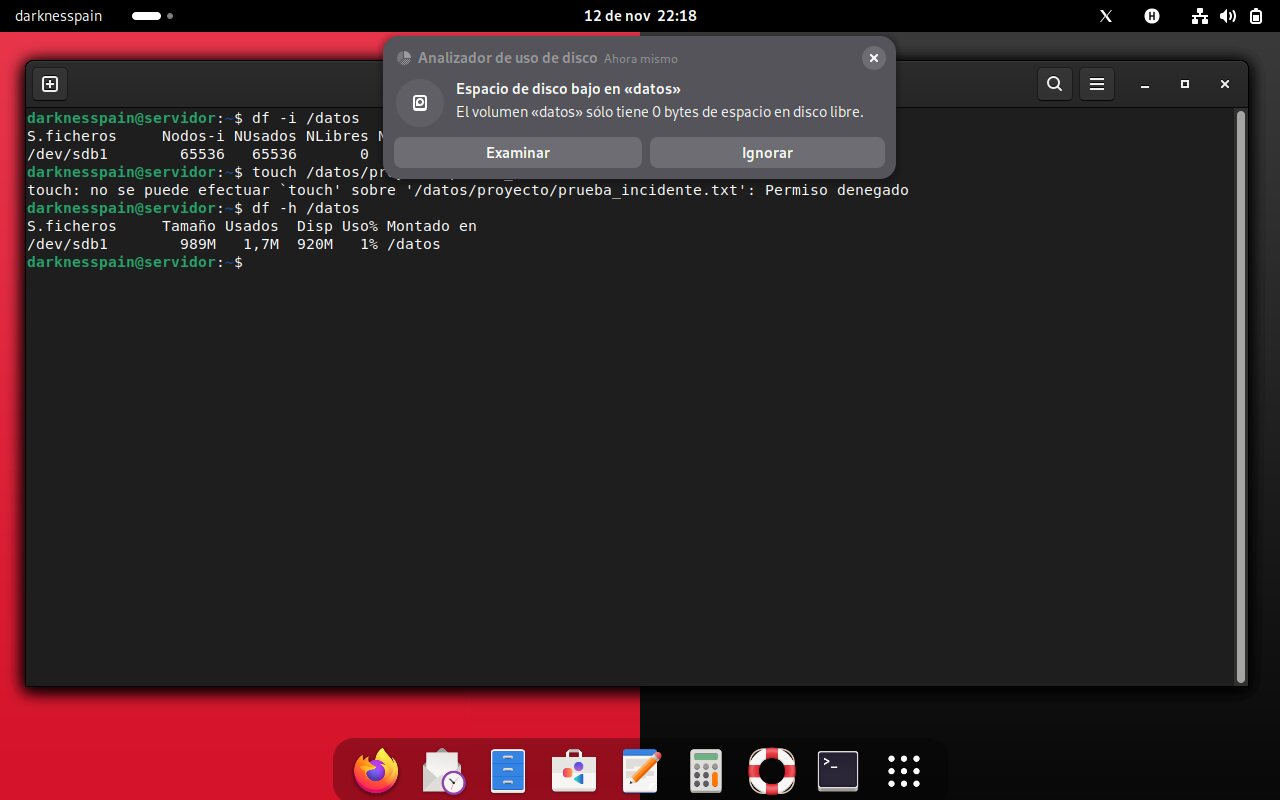
El mismo mensaje, pero df -h muestra espacio disponible (1 %).

Diagnóstico

df -i /datos marca 100 %; ls -f … | wc -l cuenta las entradas.

Evidencia

65 511 entradas para 65 536 inodos: el sistema de archivos se quedó sin metadatos, no sin bloques.

Causa raíz

Millones de archivos diminutos en una carpeta de sesiones.

Solución

Limpiar las entradas sobrantes y volver a comprobar con df -i.

Prevención

Monitorear inodos, no solo bloques; alertar antes del 90 %.

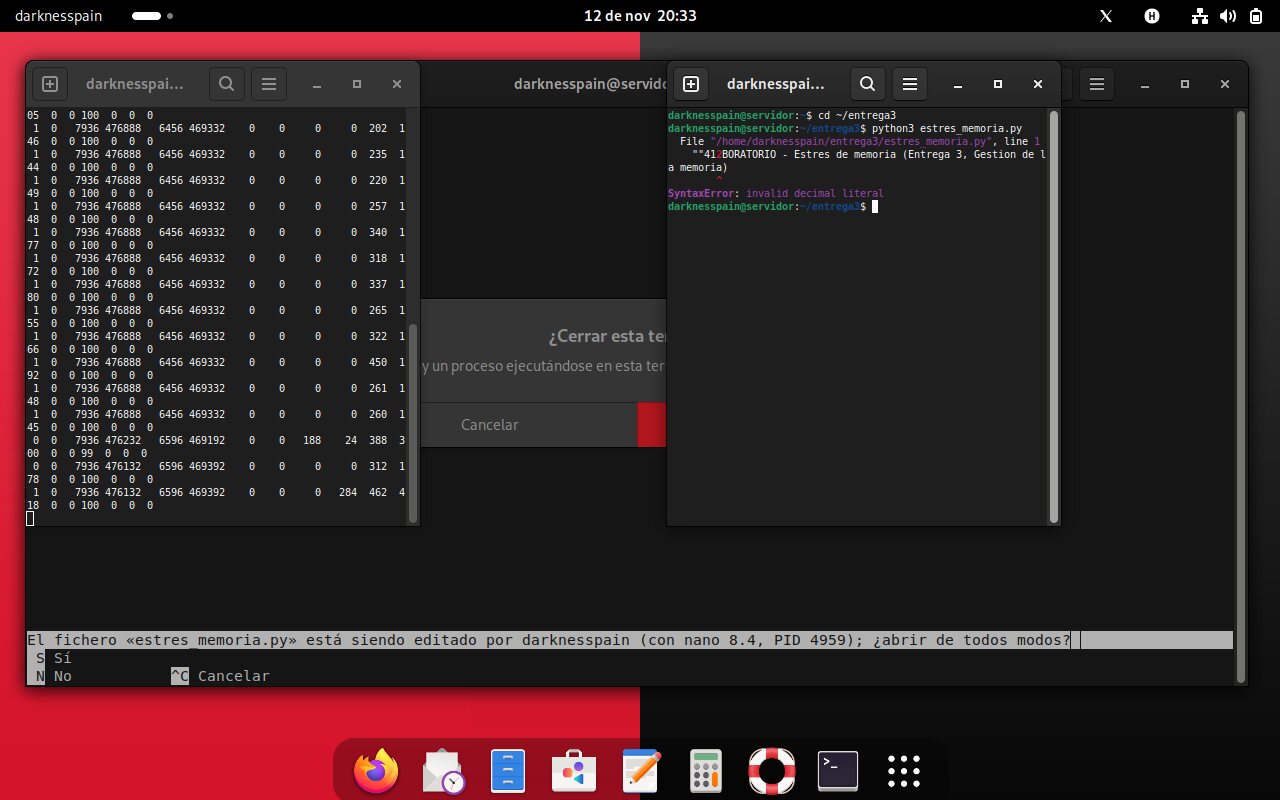
Síntoma

Todo va lento; el disco trabaja sin que nadie lo use.

Diagnóstico

free -m, vmstat 1 (si/so), ps -eo pid,comm,rss --sort=-rss.

Evidencia

Proceso 9238 (estres_memoria.py) con RSS alto y swap creciendo; la máquina sigue respondiendo, pero paginando.

Causa raíz

Una reserva de 1125 MB mayor que la RAM disponible.

Solución

kill al proceso; la memoria se recupera sin reiniciar.

Prevención

Límites (systemd, ulimit) y monitoreo de swap.

Síntoma

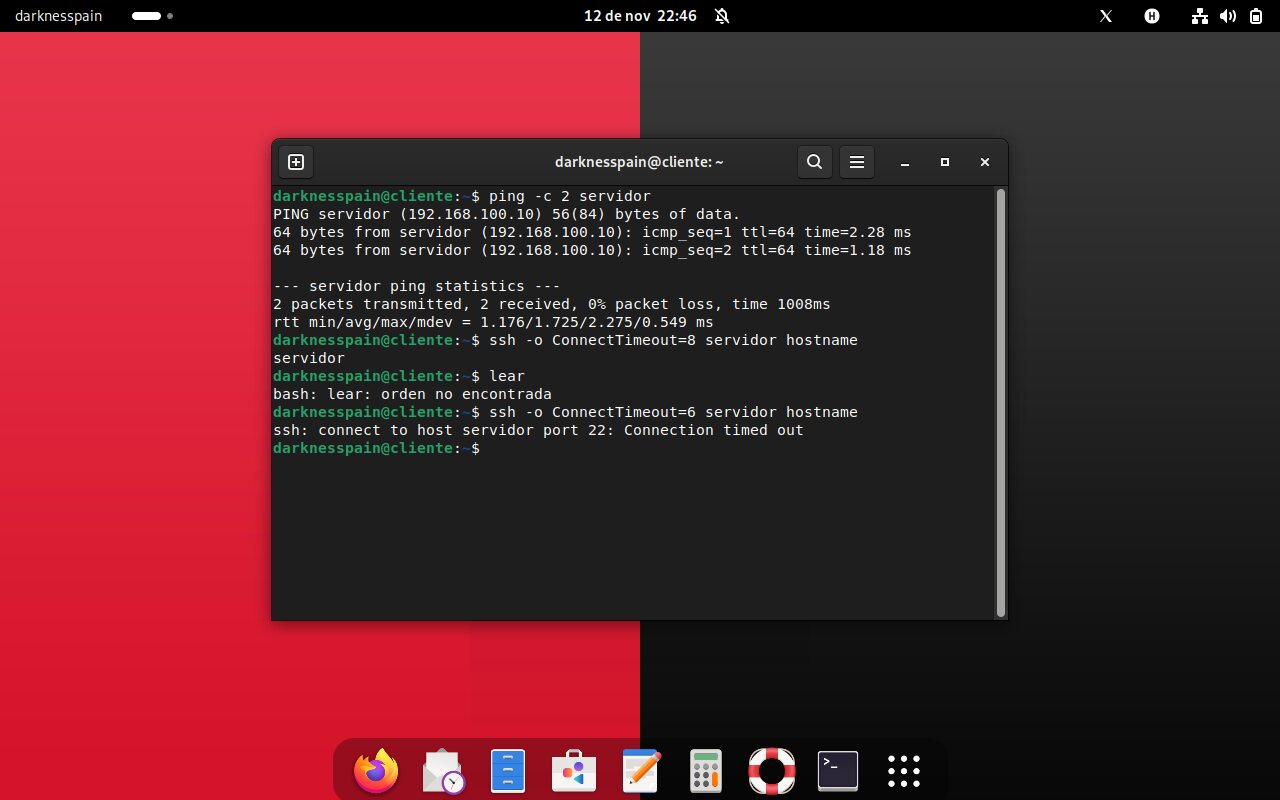
ssh servidor se queda esperando y no conecta.

Diagnóstico

ping servidor responde (la red está bien); en el servidor, systemctl status ssh está activo y ufw status no muestra el 22.

Evidencia

La regla 22/tcp había sido eliminada con ufw delete allow 22/tcp.

Causa raíz

El cortafuegos, no la red ni el servicio.

Solución

Volver a permitir el 22 y comprobar desde el cliente.

Prevención

Permitir SSH antes de activar ufw y probar siempre en una segunda terminal.

La lección de F

Dos causas, un mismo mensaje

«No space left on device» no siempre significa «disco lleno». Si df -h tiene espacio y df -i está al 100 %, el problema son los inodos: hay demasiados archivos, no demasiados datos.

df -h100 %faltan bloques
df -i100 %faltan inodos
Disco lleno
Fig. F.1 bloques agotados
Inodos agotados
Fig. F.2 inodos agotados
SSH bloqueado
Fig. F.3 SSH sin puerta
G

Parte G — Cierre

Veinte de veinte.
Y la prueba de qué cambió.

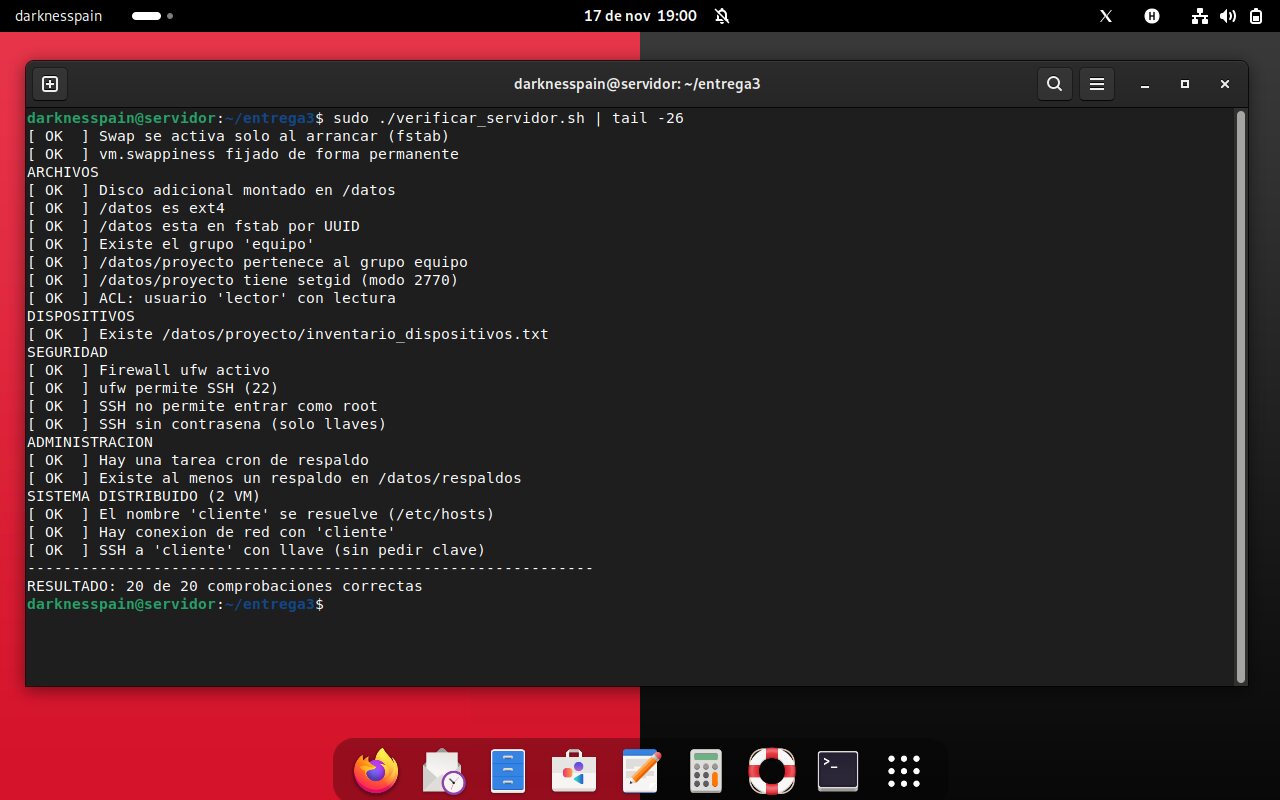
El verificador recorre memoria, archivos, dispositivos, seguridad, administración y el sistema de dos nodos. La línea base se vuelve a tomar y se compara con la del primer día.

20/20

comprobaciones correctas

Ver la captura

Memoria 03

  • Swap activo (/swapfile)
  • Swap se activa al arrancar
  • vm.swappiness permanente

Archivos 07

  • /datos montado · ext4
  • fstab por UUID
  • grupo equipo · setgid 2770
  • ACL de lector

Dispositivos 01

  • inventario_dispositivos.txt

Seguridad 04

  • ufw activo · 22 permitido
  • root sin login · solo llaves

Administración 02

  • cron de respaldo
  • al menos un respaldo

Dos nodos 03

  • cliente resuelve · ping
  • SSH con llave
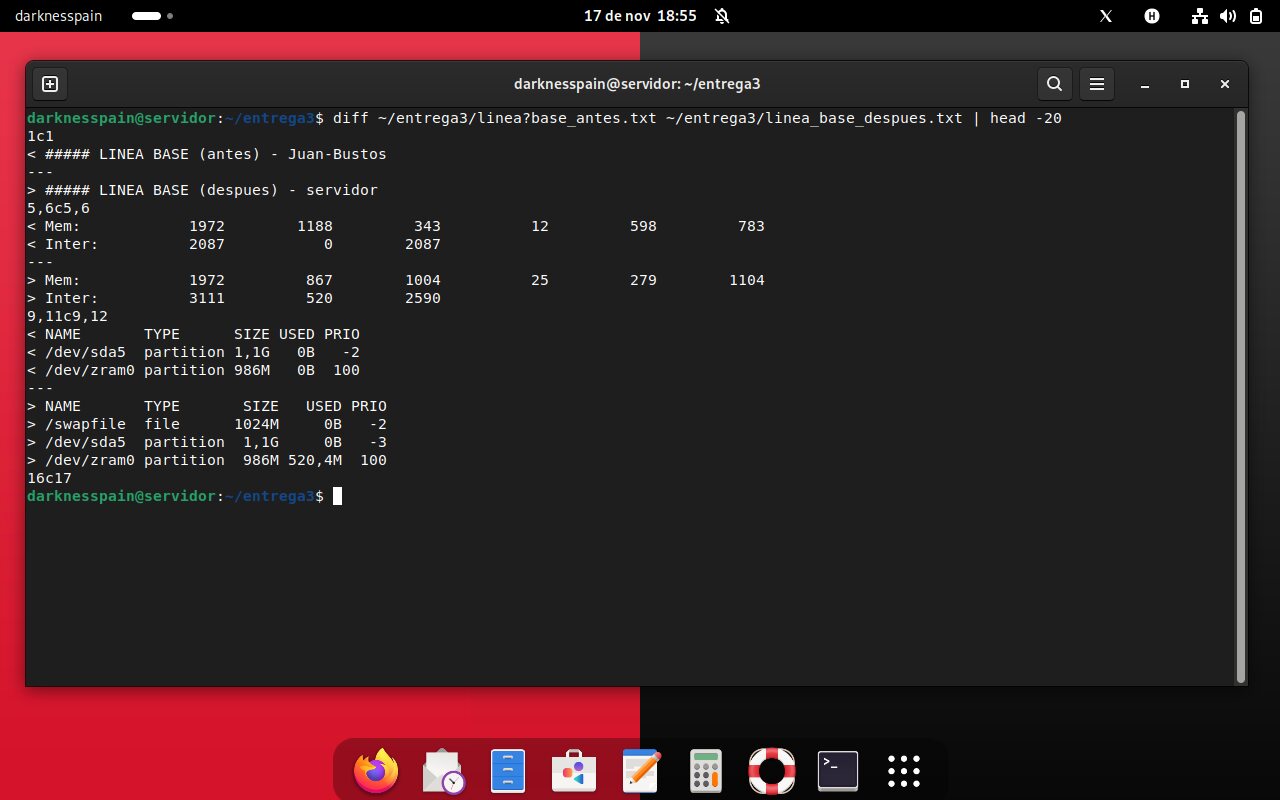
diff linea_base_antes.txt linea_base_despues.txtresumen
AspectoAntes · Entrega 1Después · Entrega 3
Swap activo2 087 MB · sda5 + zram03 111 MB · + /swapfile
Discos y montajessda1 en /+ sdb1 ext4 en /datos
Puertos en escucha22/tcp22/tcp (sin cambios)
Usuariosroot, darknesspain+ lector
Grupossudo+ equipo (gid 1001)
Interfacesenp0s3 · 10.0.2.15+ enp0s8 · 192.168.100.10
SSHcontraseña permitidasolo llaves · root no
Respaldos—cron cada 5 min · 5 copias
Diff de la línea base
Fig. G.1 diff antes/después
Runbook

Manual del administrador

Datos del sistema, protección, rutinas automáticas, restauración de un respaldo y una guía síntoma → comando → qué buscar.

Bitácora

Comandos por función

Memoria, archivos, dispositivos, seguridad, llaves, respaldos, diagnóstico y verificación: cada comando con su propósito.

Sustentación

Predecir antes de ejecutar

Tres comandos al azar: qué hace, qué salida se espera y qué diferencia apareció. La nota es individual.

Conclusiones

Un servidor no es el que no falla.
Es el que se puede reparar.

«El servidor quedó operable, seguro y documentado: memoria administrada con un área de intercambio propia y una política de swappiness explícita, un disco de datos montado por UUID con permisos de grupo y ACL, un cortafuegos con una sola puerta abierta, SSH sin root y sin contraseñas, respaldos automáticos cada cinco minutos con copia en la segunda máquina y un verificador que responde 20 de 20.»

Informe de la Entrega 3

Preguntas 13–20

Ocho preguntas para cerrar

Las respuestas usan los números medidos en esta entrega, no los del libro.

El espacio de direcciones es una promesa, no una reserva. gnome-shell mostraba VSZ de 5,3 GB con 1 972 MB de RAM porque las páginas se asignan solo al tocarlas (paginación por demanda). Cuando la RAM se llena, el kernel escribe páginas al swap y, al volver a pedirlas, se leen del disco: un fallo mayor. Con 1 125 MB reservados el swap llegó a 446 MB; con swappiness 60, a 385 MB y 26 fallos mayores. El precio es tiempo, no capacidad.

LRU o su aproximación real, el reloj de segunda oportunidad, porque cumple la propiedad de pila y usa el bit de referencia que ya mantiene el hardware. El Óptimo exige conocer el futuro, así que solo sirve como cota. Belady enseñó que más memoria no garantiza menos fallos: FIFO pasó de 9 a 10 al subir de 3 a 4 marcos; LRU y Óptimo mejoraron.

Bloques agotados: servicio.log llegó a 1 019 318 272 bytes y df -h marcó 100 %. E inodos agotados: 65 511 entradas para 65 536 inodos, con df -h al 1 % y df -i al 100 %. Se distinguen con una sola orden: si df -h tiene espacio y df -i no, sobran archivos, no datos.

El setgid hace que los archivos nuevos hereden el grupo de la carpeta: mi_archivo.txt nació con grupo equipo, no con el grupo del usuario. La ACL concede r-x a lector sin abrir la carpeta a «otros»; con chmod la única alternativa habría sido dar permiso a todo el mundo. La diferencia es granularidad, y el coste es documentarla porque ls -l no la muestra.

Encuesta es mirar el timbre cada diez segundos; interrupción es que suene. El dispositivo avisa cuando hay un evento y la CPU deja de gastar ciclos preguntando; la encuesta conviene cuando los eventos son masivos y predecibles, y los kernels modernos combinan ambas (NAPI). El driver traduce: conoce los registros del dispositivo y expone una interfaz uniforme, por eso ping no necesita saber que la tarjeta es una Intel 82540EM con módulo e1000.

Se vio tolerancia a fallos mínima e independencia de fallos: cada máquina tiene su kernel y su memoria, y el servidor no se enteró de que el cliente desapareció. Faltan réplica del servidor, heartbeat o detector de fallos, quórum y consenso, y una copia fuera de las dos máquinas. Para la entrega bastaba demostrar supervivencia; un montaje real necesita redundancia.

Seguridad: ufw con una sola puerta, SSH sin root y sin contraseñas, setgid y ACL en /datos/proyecto. Disponibilidad: swap y swappiness, montaje con nofail, respaldos automáticos y verificador. El resto —disco por UUID, usuario lector, grupo equipo, interfaz interna— completa el cuadro. Seguridad y disponibilidad no son opuestas: cada cambio bien hecho aporta a una sin quitarle a la otra.

Cuando un servidor va lento, las tres capas aparecen juntas. El síntoma es un proceso: se lee con ps/top y se termina con kill; el mismo programa de 1 125 MB apareció con RSS alto y obligó a mirar el swap. La cadena es siempre la misma: carga alta → proceso → memoria real → paginación → disco. Administrar es preguntar en el orden correcto —qué proceso, cuánta memoria, qué disco— y no adivinar.

Evidencias

Capturas reales,
no recreaciones.

Cada imagen salió de la máquina virtual durante la práctica. Pulsa para ampliar y leer la explicación.

Entregables

Lo que queda
sobre la mesa.